NCCL 是什么?多 GPU 训练的通信、调优与故障排查入门 | GPU 调试系列 #2
多张 GPU 一起训练同一个模型时,需要不断交换数据。NCCL 就是 NVIDIA GPU 训练中常用的通信库。本文围绕四个问题展开:NCCL 负责什么、它如何选择传输路径、怎样验证性能,以及训练变慢或卡住时该从哪里查起。
读懂 NVIDIA Xid 错误码:GPU 故障排查入门 | GPU 调试系列 #1
本文面向刚接触 NVIDIA GPU 运维的读者,从 Xid 是什么、到哪里查找、如何解读讲起,再以掉卡(Xid 79,GPU has fallen off the bus)和 ECC 错误(Xid 48/63/64/92/94/95)这两类常见问题为例,介绍...
AI 超级计算机的高速公路:从 GB200/GB300 看懂 RDMA 网络
只要你大致知道“CPU、内存、网络”是什么,就能从头读到尾。我们会从“AI 为什么需要网络”讲起,一路深入到 NVIDIA GB200/GB300 机架内的三层网络架构,以及 RDMA 这项让十万颗 GPU 像一台计算机一样协同工作的关键技术。
AI 时代的技术面试:一场规则正在被改写的博弈
最近读到 Coinbase 工程团队发表的《Interviewing Engineers in the AI Era》,讲述他们如何用一整年重建技术面试流程。1沿着这条线索,我梳理了 Canva、Meta、Google、Datadog 等公司的最新实践与行业数据,越看越确定一件事:当 Coinbase 在 2025 年第四季度合并的代码中已有一半以上由 AI...
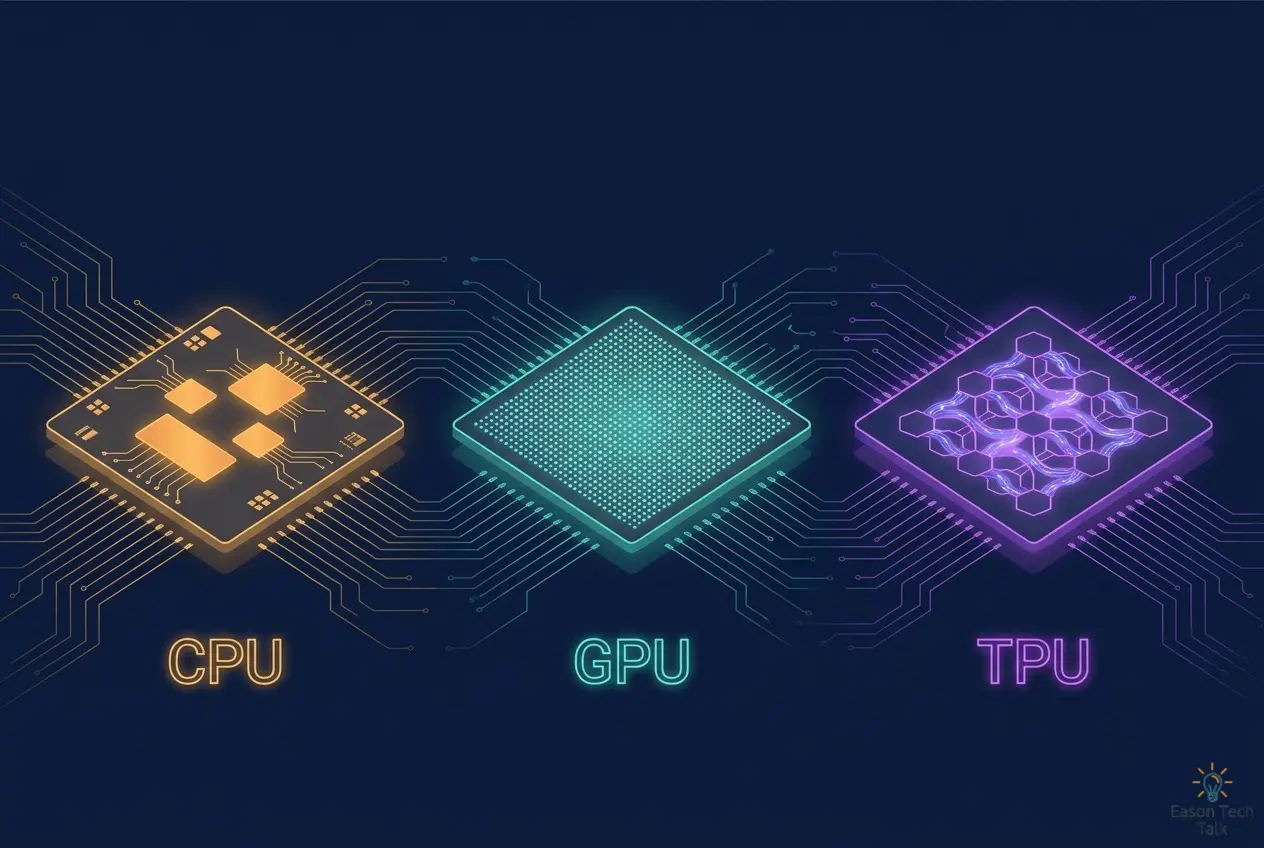
CPU、GPU 和 TPU 到底有什么区别?零基础也能看懂的芯片指南
一句话总结:CPU 是什么都会的“全能主厨”,GPU 是能够同时制作上千道菜的“大型厨房团队”,TPU 则是只专注于一道菜、但做得又快又省电的“自动化中央厨房”。
Linux 面试经典:buff 和 cache 到底有什么区别?用 vmstat 看懂 Page Cache 与 Buffer Cache
buff 和 cache 都会使用内存临时存放数据,它们到底有什么区别?“我的 free 内存怎么只剩一点了,系统是不是快要出问题了?”
16 小时通过 NVIDIA NCA-AIIO:备考计划与 7 大考试重点
我最近通过了 NVIDIA-Certified Associate: AI Infrastructure and Operations(NCA-AIIO) 认证考试。本文将分享我的备考方法、考试重点,以及在准备过程中发现值得深入研究的主题,希望帮助你更高效地准备这项考试。
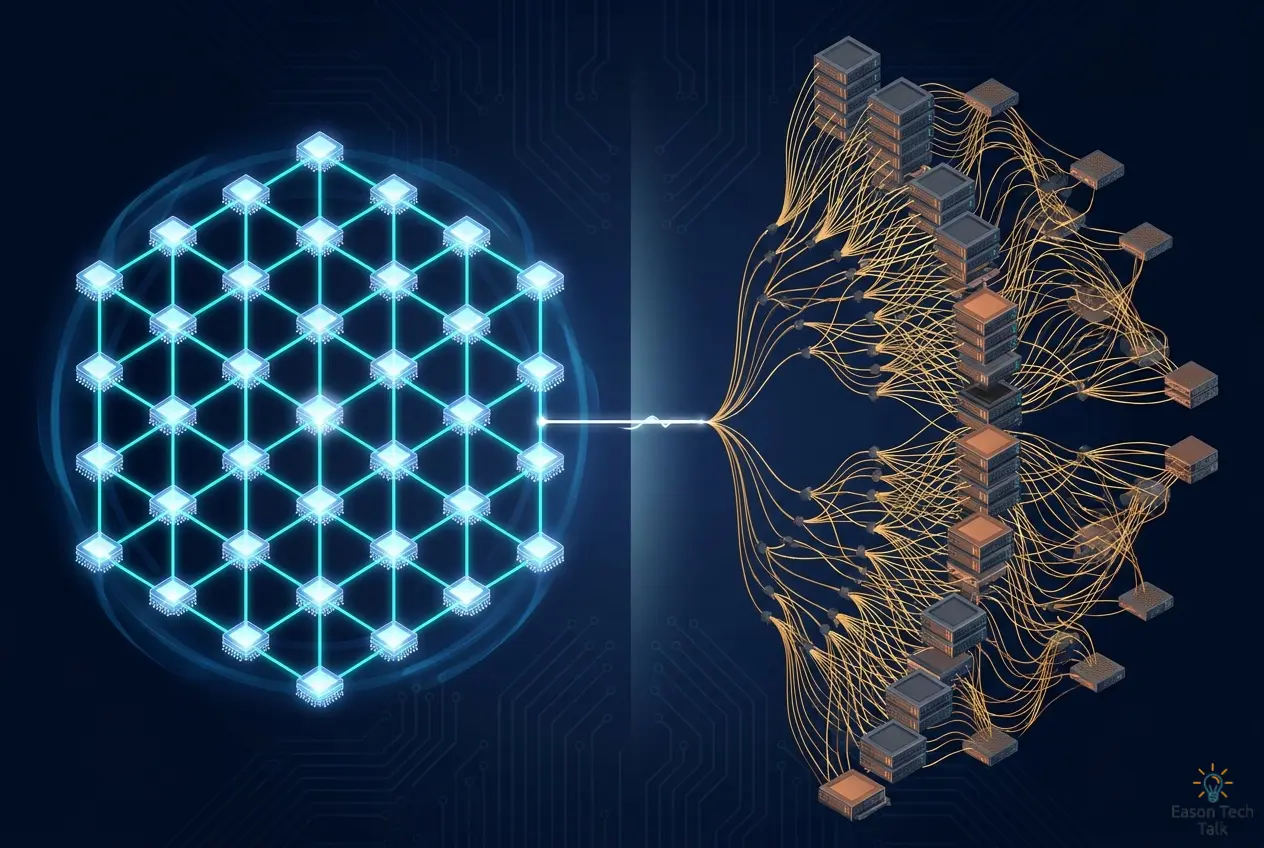
TPU 的 4x4x4 到底在乘什么?一篇看懂 TPU Slice 与 GPU 设计哲学
刚开始学习 TPU 架构时,规格中 4x4x4、8x16、16x16 这类 slice(切片)尺寸让我十分困惑。当下冒出一连串疑问:为什么是“几乘几”?这些数字是矩阵乘法的维度吗?为什么 GPU 的世界好像不用管这些,TPU 却要把拓扑搞得这么复杂?
AI 有意识吗?为什么 ChatGPT 这么好用却常一本正经地出错
最近跟身边的人聊天,发现大家对 AI 的想象差异大得惊人:有人受电影影响,担心 AI 哪天会毁灭人类(觉得它快要有意识了),有人觉得它只是高级一点的搜索引擎或聊天机器人。本文尝试回答一个更实际的问题:我们手上的 AI 到底是什么?它为什么有时非常有用,又为什么常在关键时刻很笨?
Oncall 心态指南:Dropbox 与 AWS 顶尖工程师如何看待事故应对与复盘
在前一篇 Pager 没响却听见警报?Oncall 工程师的睡眠与焦虑指南 里,我主要谈的是 oncall 的代价和如何防御。这一篇想换个角度,聊的是心态。
为什么 GKE 升级会卡在 Admission Webhook 上
在日常维护 Google Kubernetes Engine (GKE) 集群时,升级版本是很正常的一部分。升级可以修补安全漏洞、保持控制平面健康,也能让你拿到新的 Kubernetes 功能。但在实际操作中,升级还是可能卡住,并在 Logs Explorer 里出现像 Internal error 或 DeployPatch...
AWS Firecracker 论文导读:AWS 为什么用 microVM 支撑 Serverless
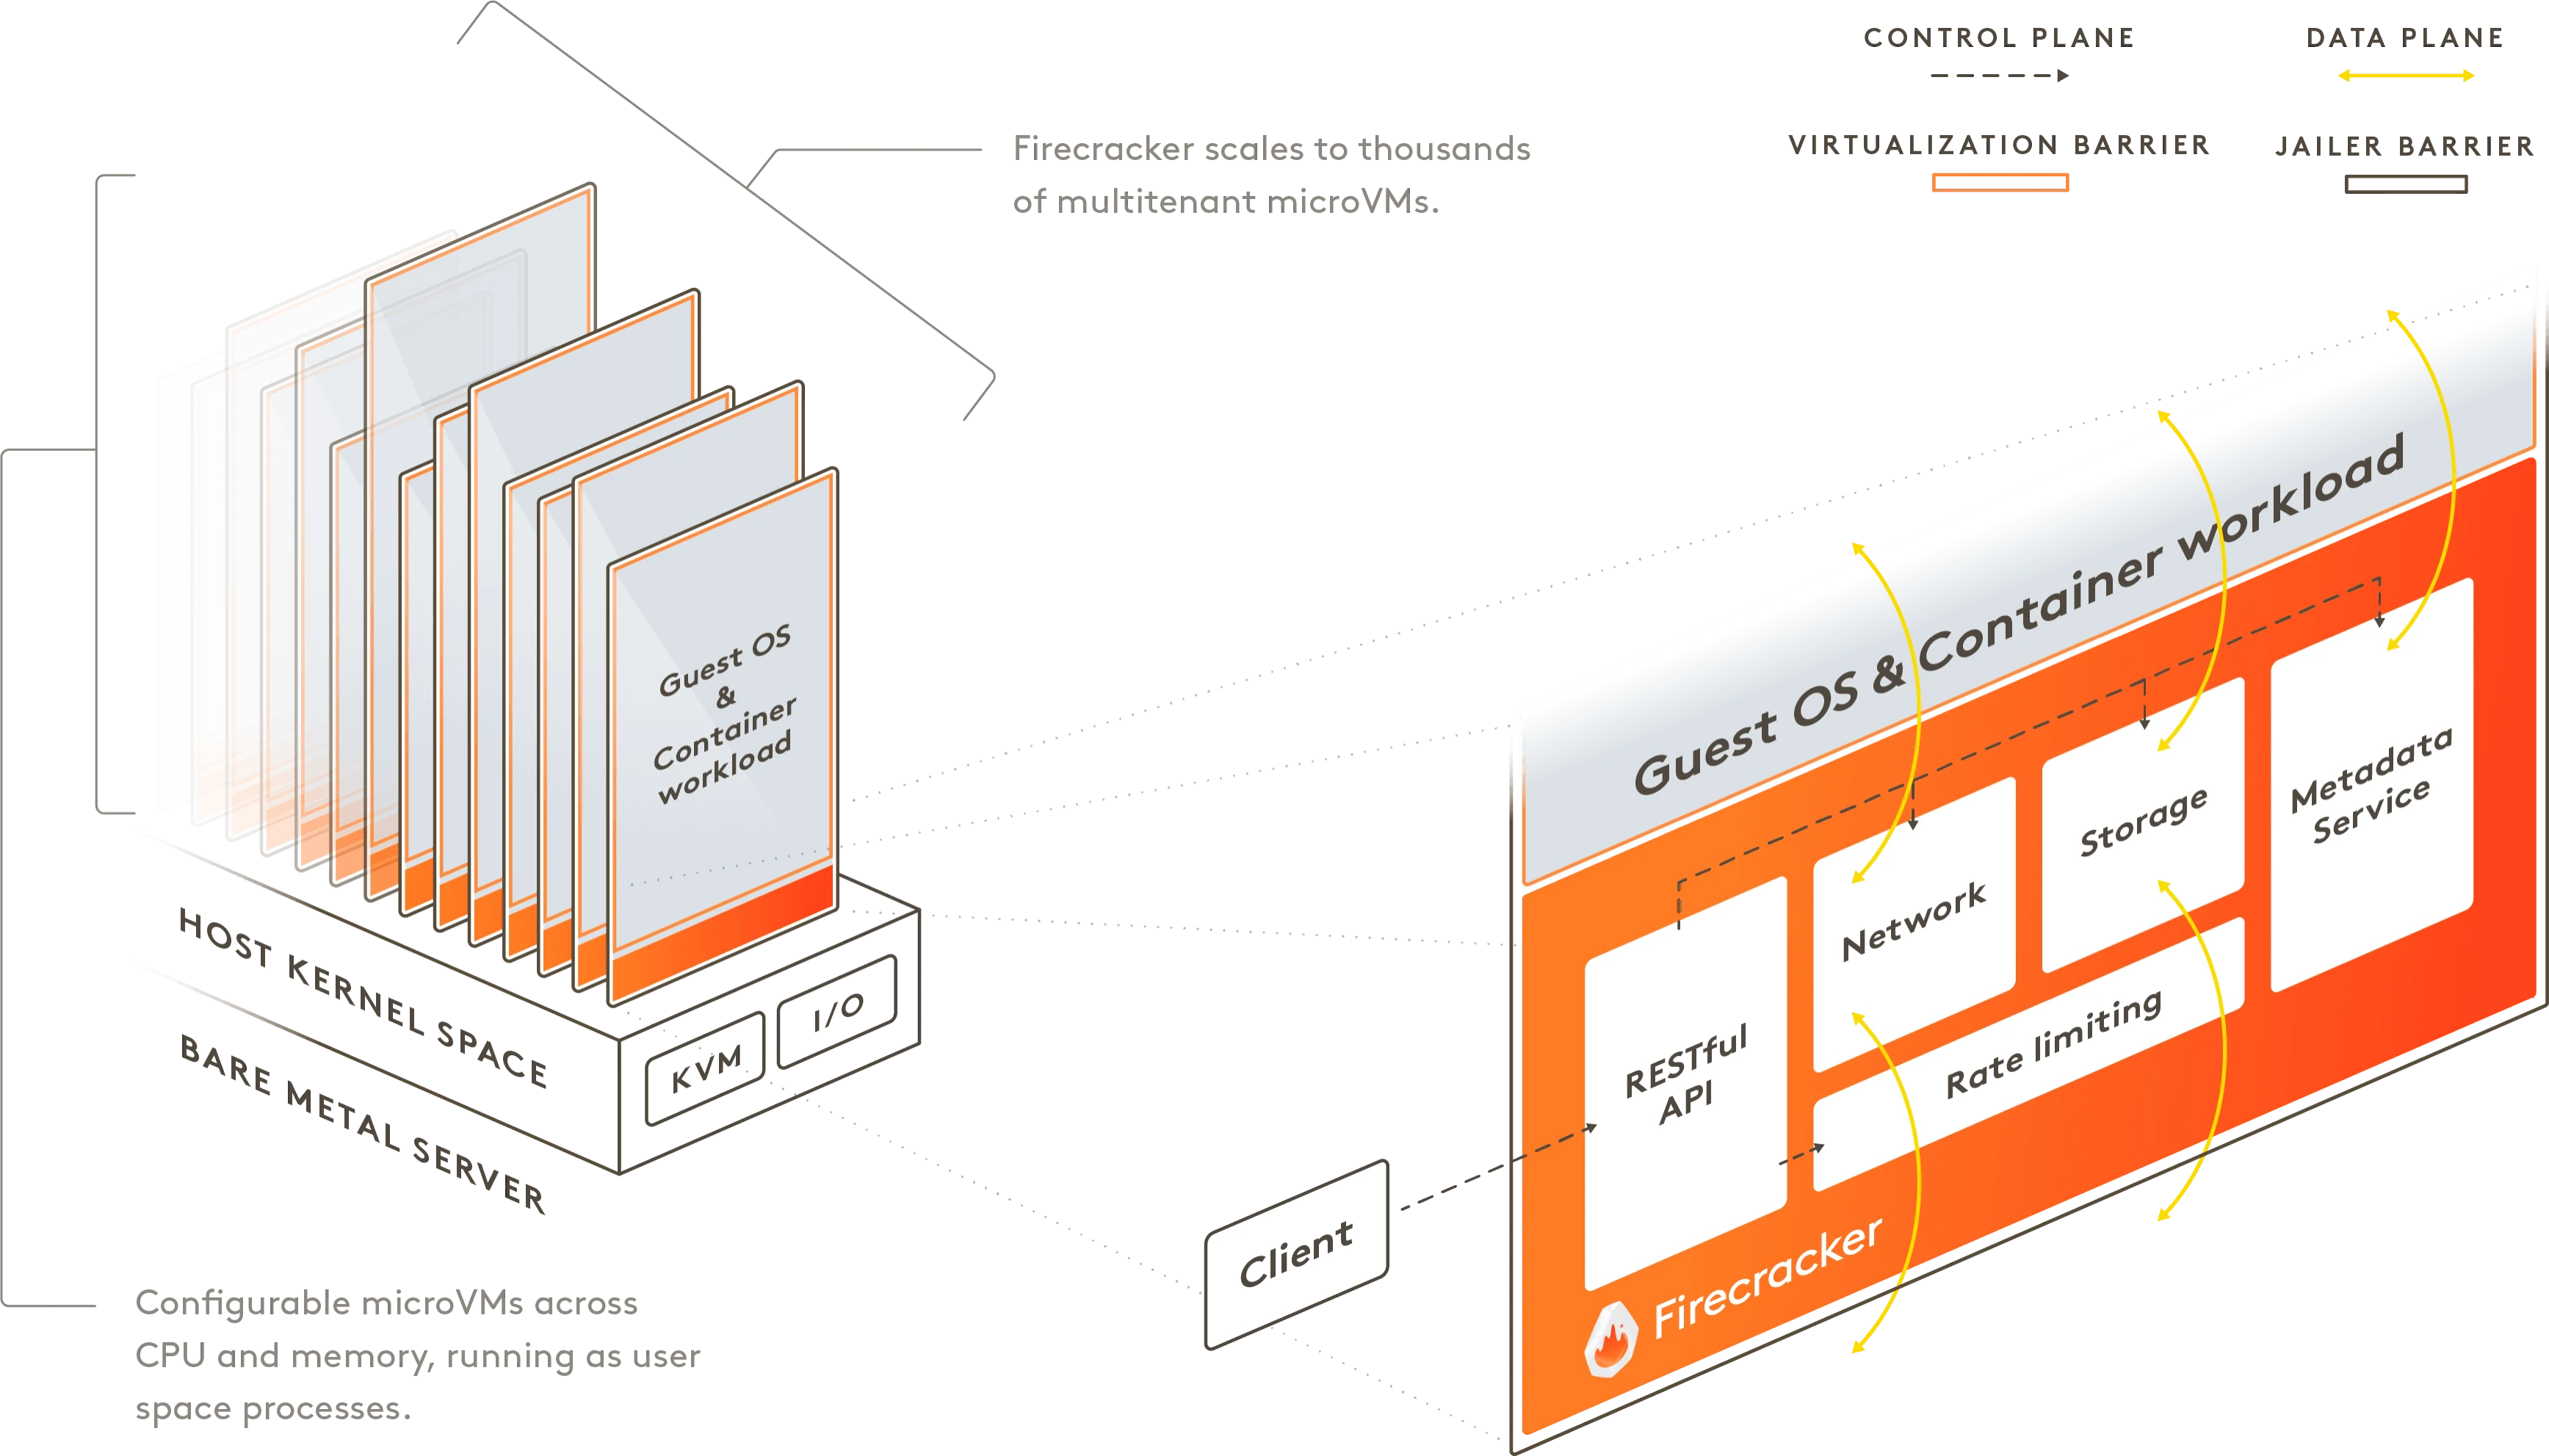
Firecracker 是 AWS 开源的 Virtual Machine Monitor,用于运行轻量级 microVM。它最常被提到的原因,是 AWS Lambda 底层使用了这项技术:AWS 需要快速启动隔离的执行环境,在大型主机上承载大量租户,同时保留用户对虚拟机隔离边界的安全预期。
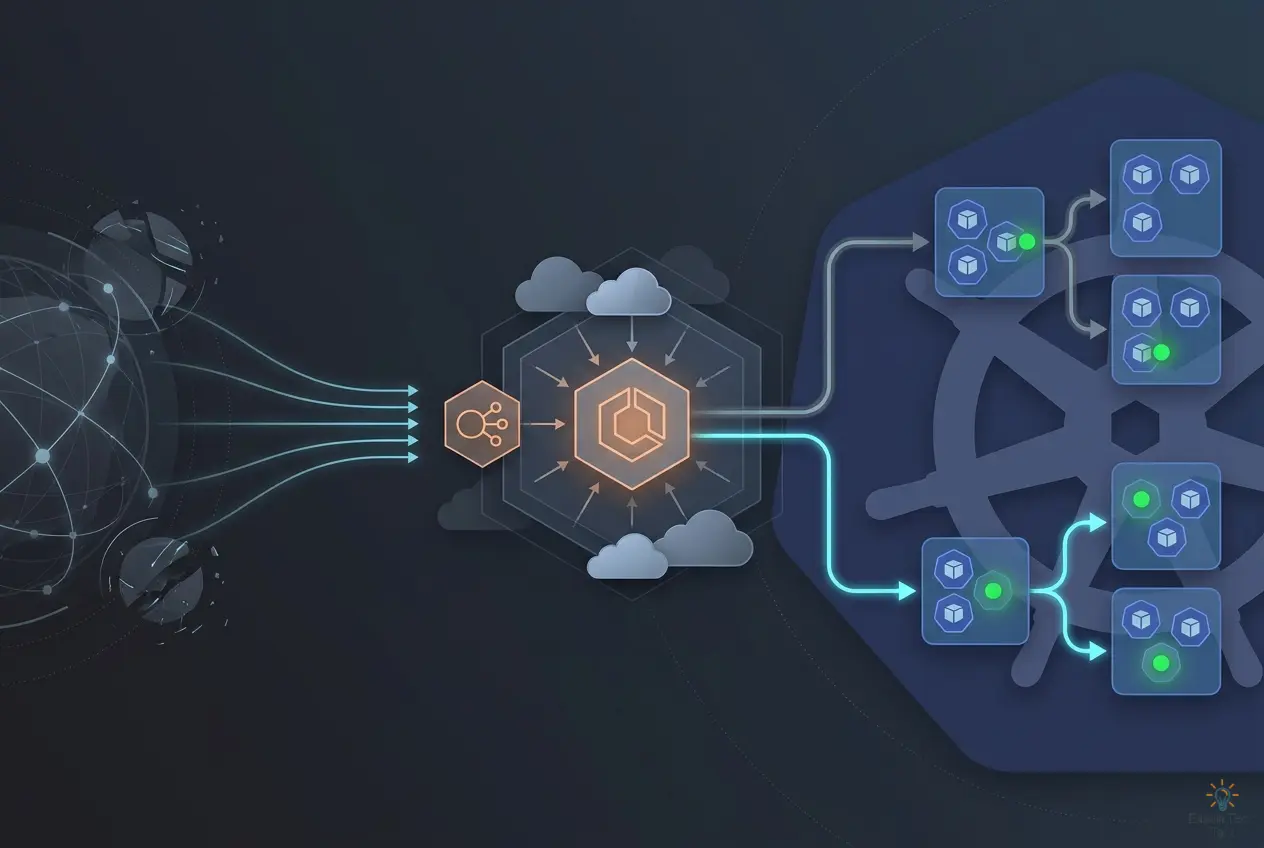
EKS Load Balancing 最佳实践:Service、NLB、ALB 与 IP Targets
在 Amazon EKS 上做 Load Balancing,看起来很简单;但只要开始追踪一个 request 到底经过哪些节点、最后打到哪个 Pod,事情就会变得复杂。
ChatGPT 越用越焦虑?AI 时代知识工作者的心理健康指南
“我同事用 AI 两小时做完我一整天的工作。我打开电脑,看着他在 Slack 上丢出来的成果,只觉得很累。”如果你也有类似的感觉,也许这篇文章能帮上忙。
Pager 没响却听见警报?Oncall 工程师的睡眠与焦虑指南
作为要值班的工程师,下面这些场景大概都不陌生:pager 没响,脑海里却隐约听到警报,拿起手机才发现只是错觉;半夜被叫醒后直接进客户会议,脑袋还没清醒就被要求回答问题;下班后想安静放空五分钟,结果脑子比工作时还停不下来;值班早就结束了,却还是会无意识地点开那些没处理完的调查。
SkipYT:支持 BYOK 的 YouTube AI 摘要工具
SkipYT 今天正式上线:一款让你粘贴 YouTube 链接,几秒内就能拿到结构化摘要与问答的 AI 工具。支持 BYOK(Bring Your Own Key),默认输出简体中文。现在就可以直接使用:skipyt.com
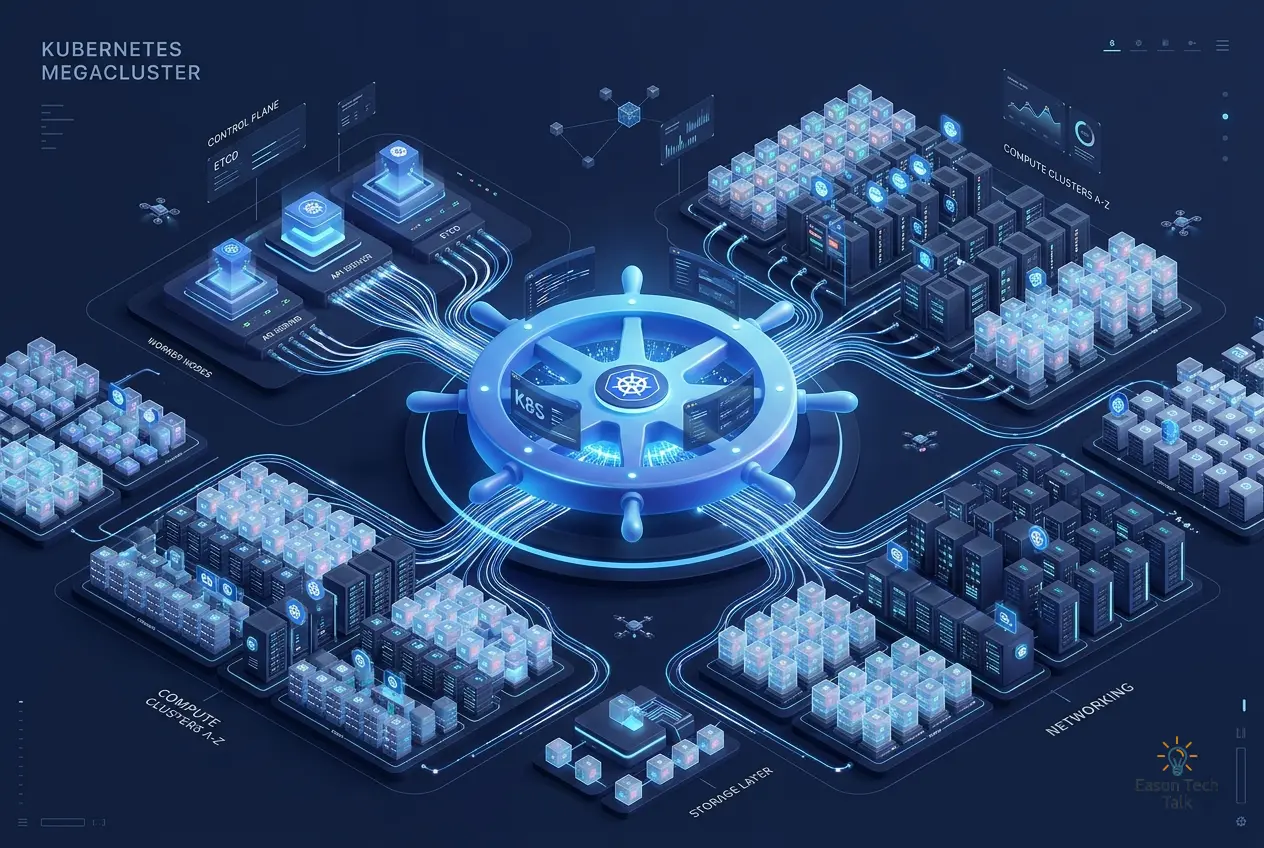
Kubernetes Megacluster 技術全景:不同平台如何突破 10K 节点门槛
在上游 Kubernetes 社区里,SIG Scalability 长期将 5,000 节点视为一个有明确可扩展性目标和运维指导支撑的“大集群”量级12。但各大云厂商和基础设施能力很强的公司,早已持续挑战这个范围。GKE 通过用 Spanner 替换 etcd,展示了 130K 节点;EKS 通过对 etcd...
EKS vs GKE:超大规模 Kubernetes 集群架构的性能深度对比(100K+ 节点)
AI 训练的爆发式增长,正在把 Kubernetes 集群推向前所未有的规模。当单个训练任务可能需要数万张 GPU 同时协作时,“一个集群究竟能撑多大”就不再是理论问题,而是实打实的基础设施决策。
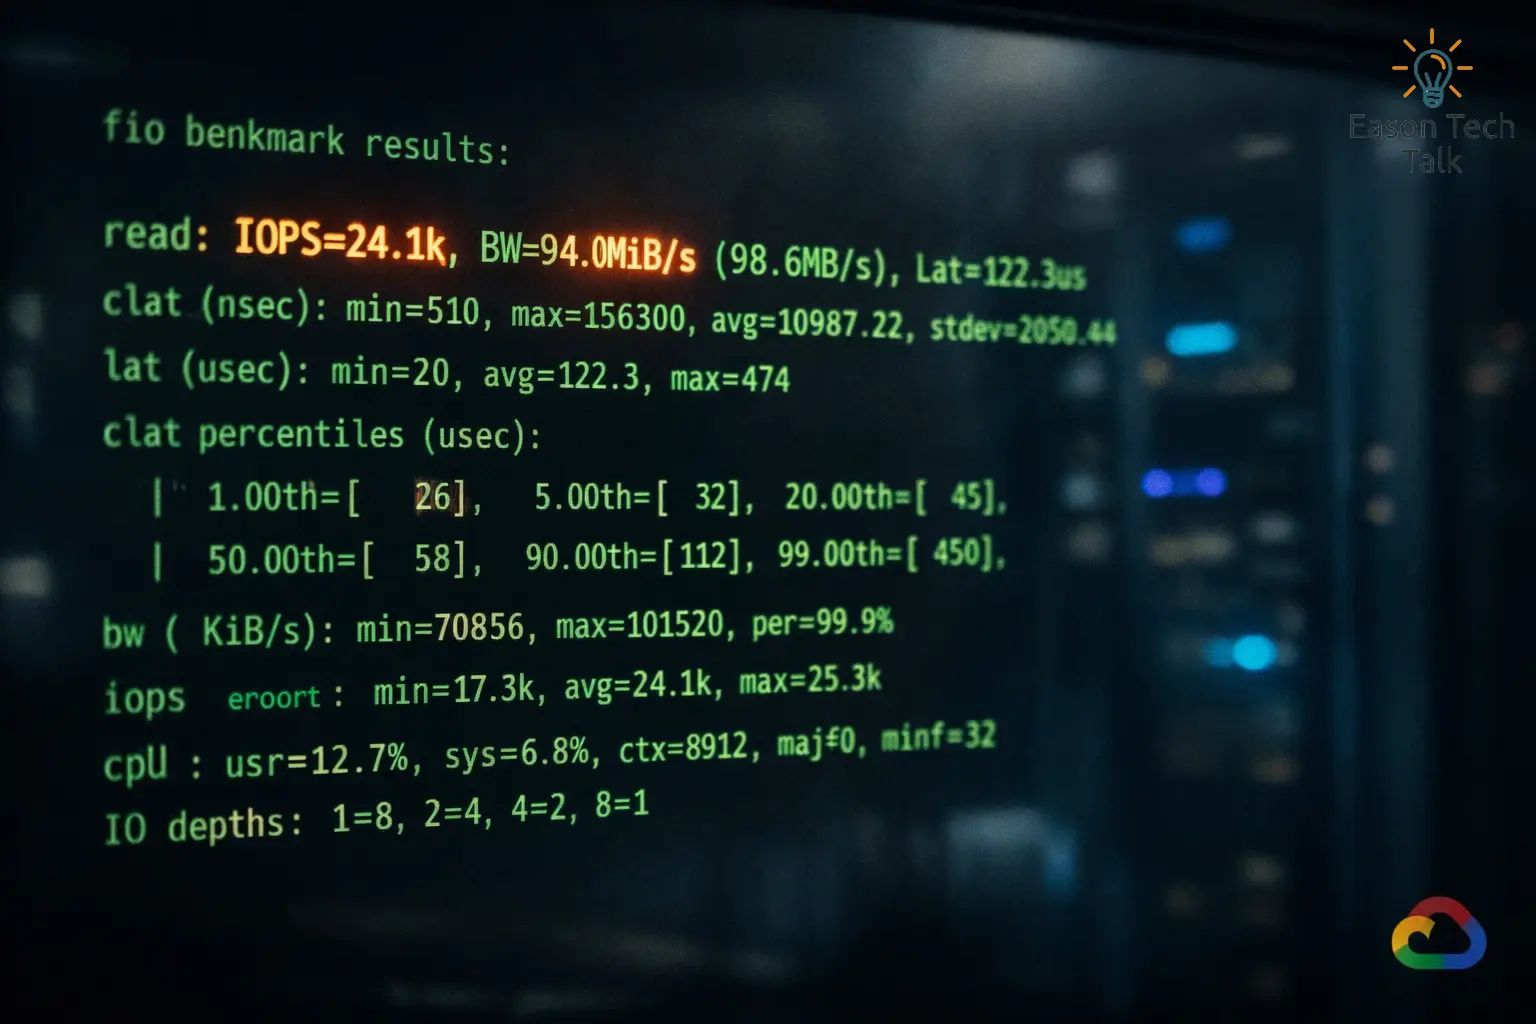
AI 训练磁盘 I/O 瓶颈排查:从 fio Benchmark 到 GCP Hyperdisk 优化实践
你有没有遇到过这种情况:在 GCP 上开了一台 VM,挂上 Hyperdisk Balanced,花钱买了 160,000 预配 IOPS(provisioned IOPS)1,满怀信心地跑了一轮 fio 压测,结果却只看到大约 2,000 IOPS? Google...
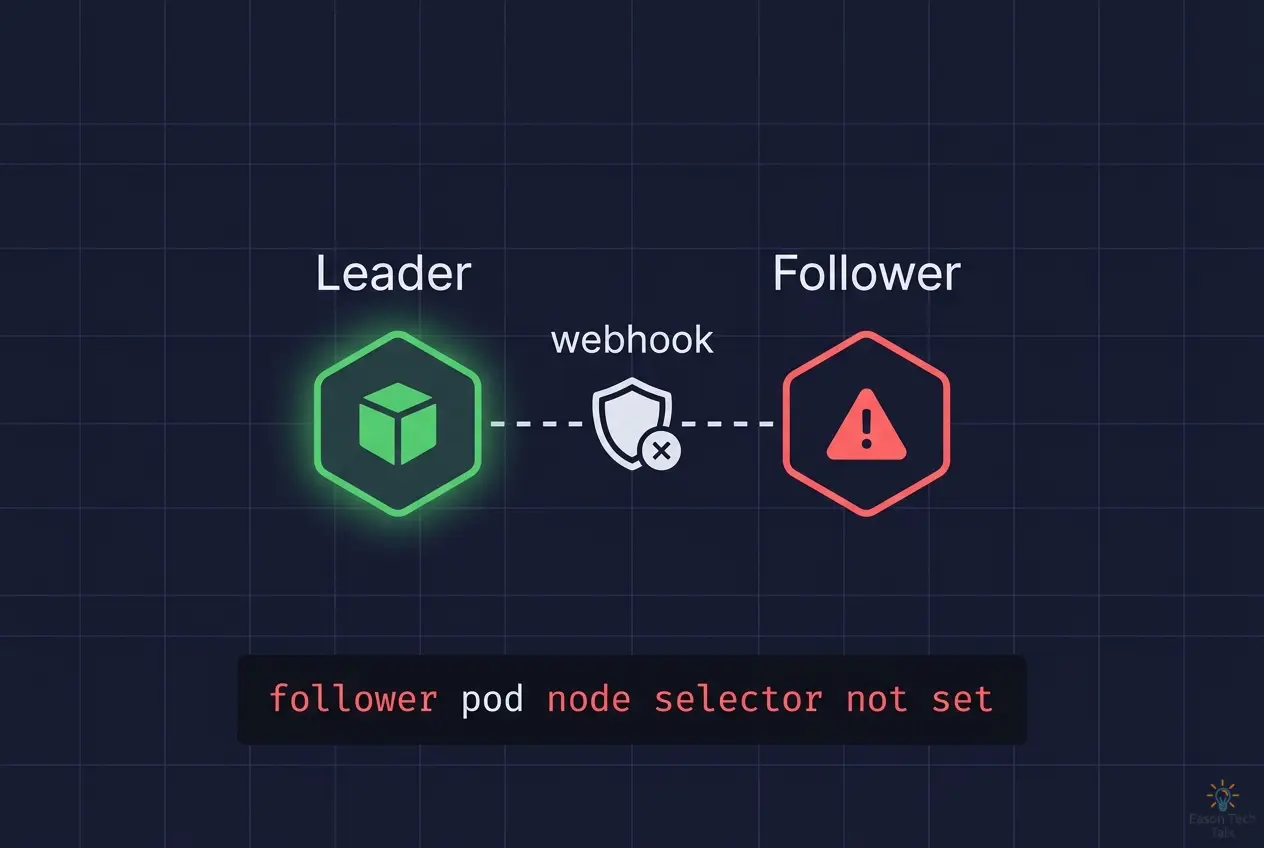
JobSet 问题排查:解决 “follower pod node selector not set” 报错
在使用 JobSet 运行 multi-slice TPU 或 GPU 分布式训练时,JobSet 的 leader-follower 机制会先调度 leader Pod,再通过 mutating webhook...
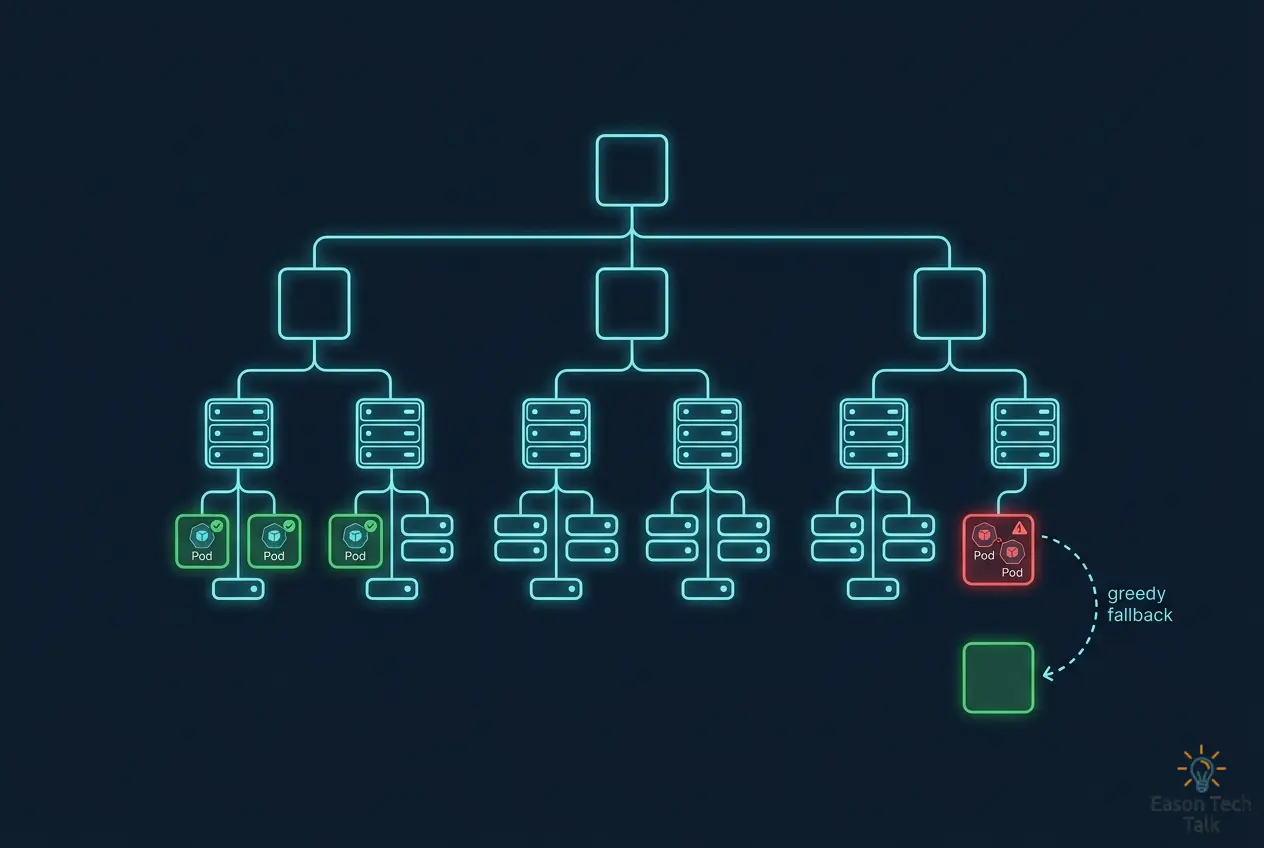
通过一个 Kueue 测试清理,看懂 TAS 的 Rank 与 Greedy Assignment
在运行 GPU 或 TPU 分布式训练时,我们通常希望同一组 Pod 被放到物理位置更接近的机器上,例如同一个机架或同一个数据中心区块。节点之间越接近,网络延迟通常越低,训练效率也越高。Kueue1 提供的 Topology Aware Scheduling(TAS)正是为了解决这个问题:它会在工作负载进入准入阶段时,基于拓扑信息提前计算出一份“每个 Pod 应该放在哪里”的放置计划。 Kueue documentation ↩...
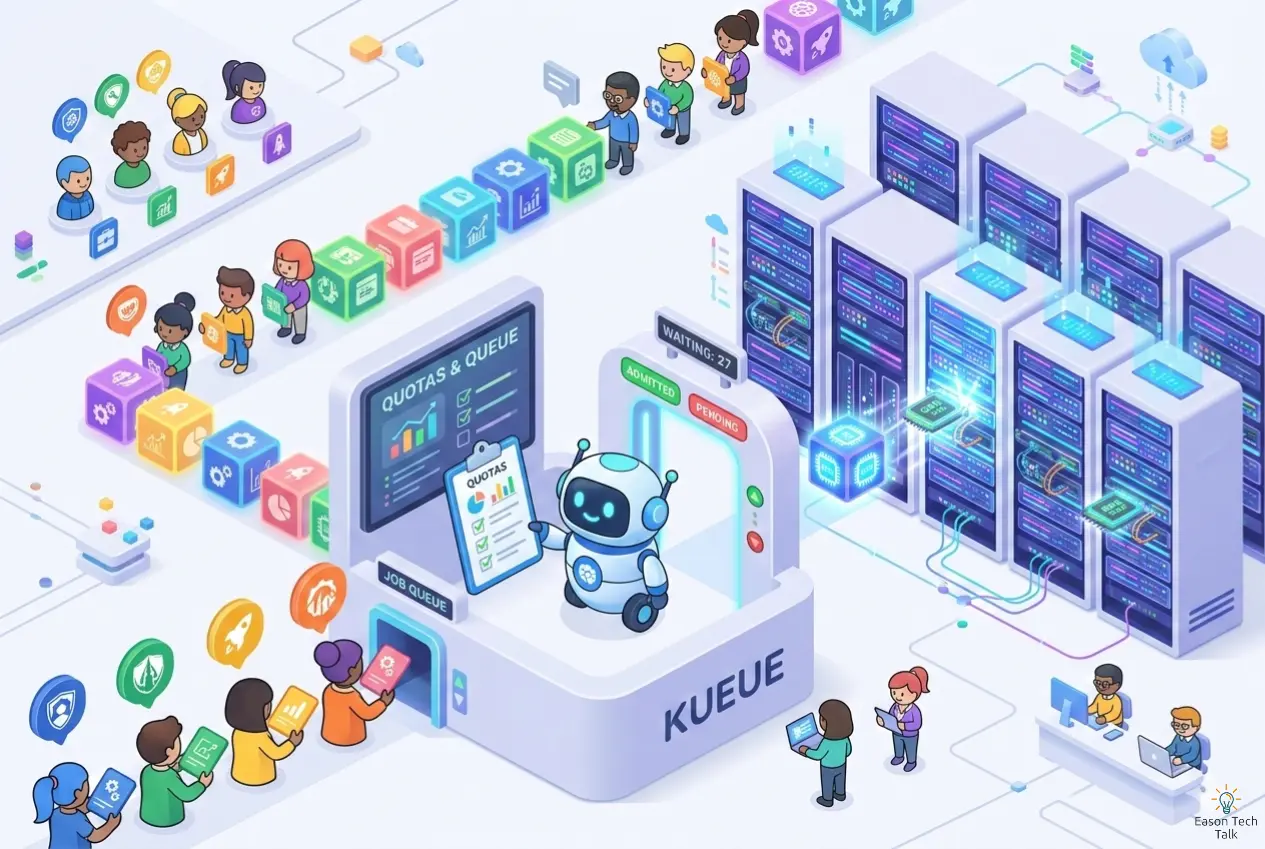
Kueue 快速上手:在 Kubernetes 上排队管理共享 GPU/TPU 资源
这篇文章会帮助你在 10 分钟内理解 Kueue 是什么、为什么需要它,以及如何在共享 GPU/TPU 集群上使用它。
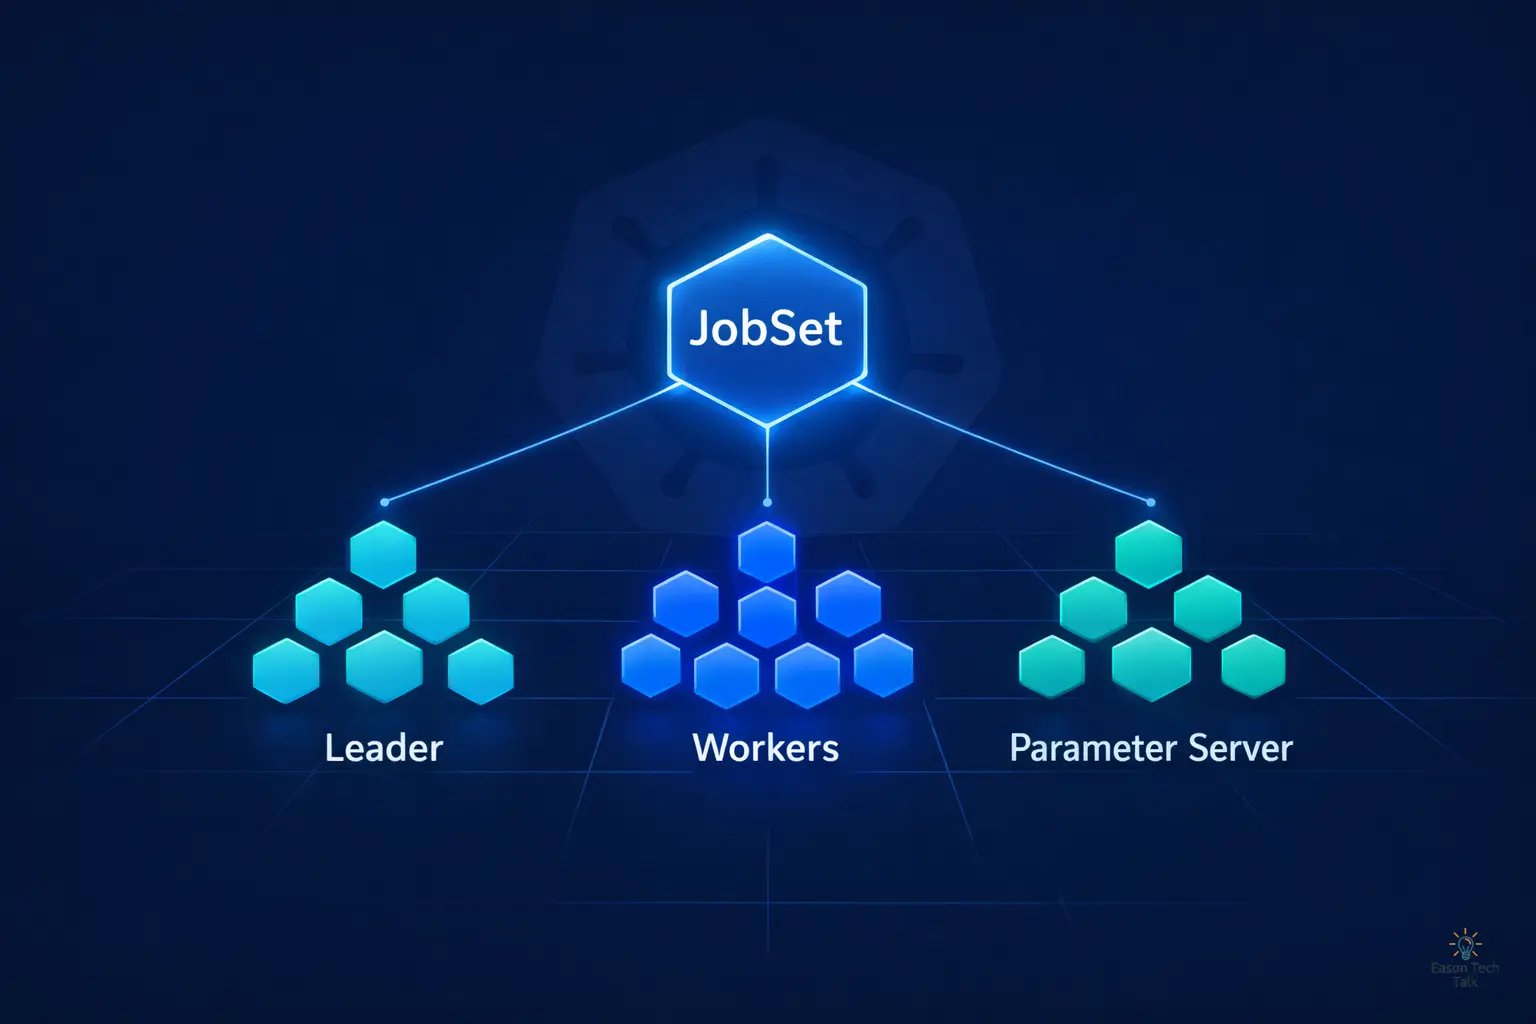
JobSet:让 Kubernetes 真正驾驭多 Job 工作负载
一句话理解 JobSet: 如果 Kubernetes Job 是“单兵作战”,JobSet 就是“协同作战的整支部队”:一个 API 对象,统一管理多组 Job 的生命周期、网络与故障恢复。
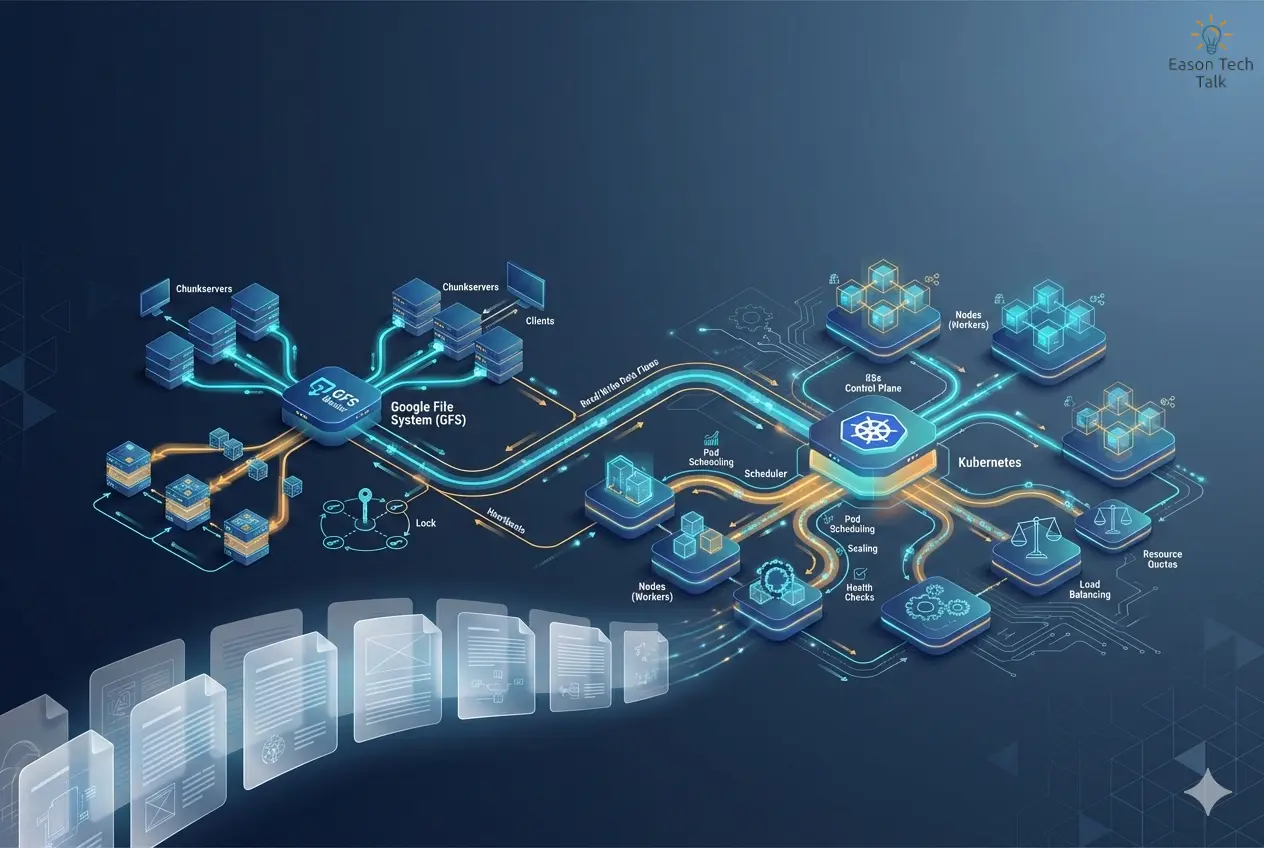
Kubernetes 工程师必读的分布式系统阅读清单
分布式系统把复杂问题拆解成有条理、可验证的步骤,让我们能打造在大规模下依旧稳定且高性能的系统。
GKE AI 系列:在 TPU 上使用 JAX 运行第一个训练作业
训练大型机器学习模型需要专用硬件。Google 的 Tensor Processing Units (TPU) 是其中最强大的芯片之一。然而,入门 TPU 并不容易——你需要了解芯片布局、配置节点池,并管理资源。在翻遍大量文档、排错数小时后,很容易迷失方向。
工程师的深度工作实践指南(让我不再累死的工作方法)
作为一名热衷于生产力的工程师,我花了很多时间研究如何提升工作效率。
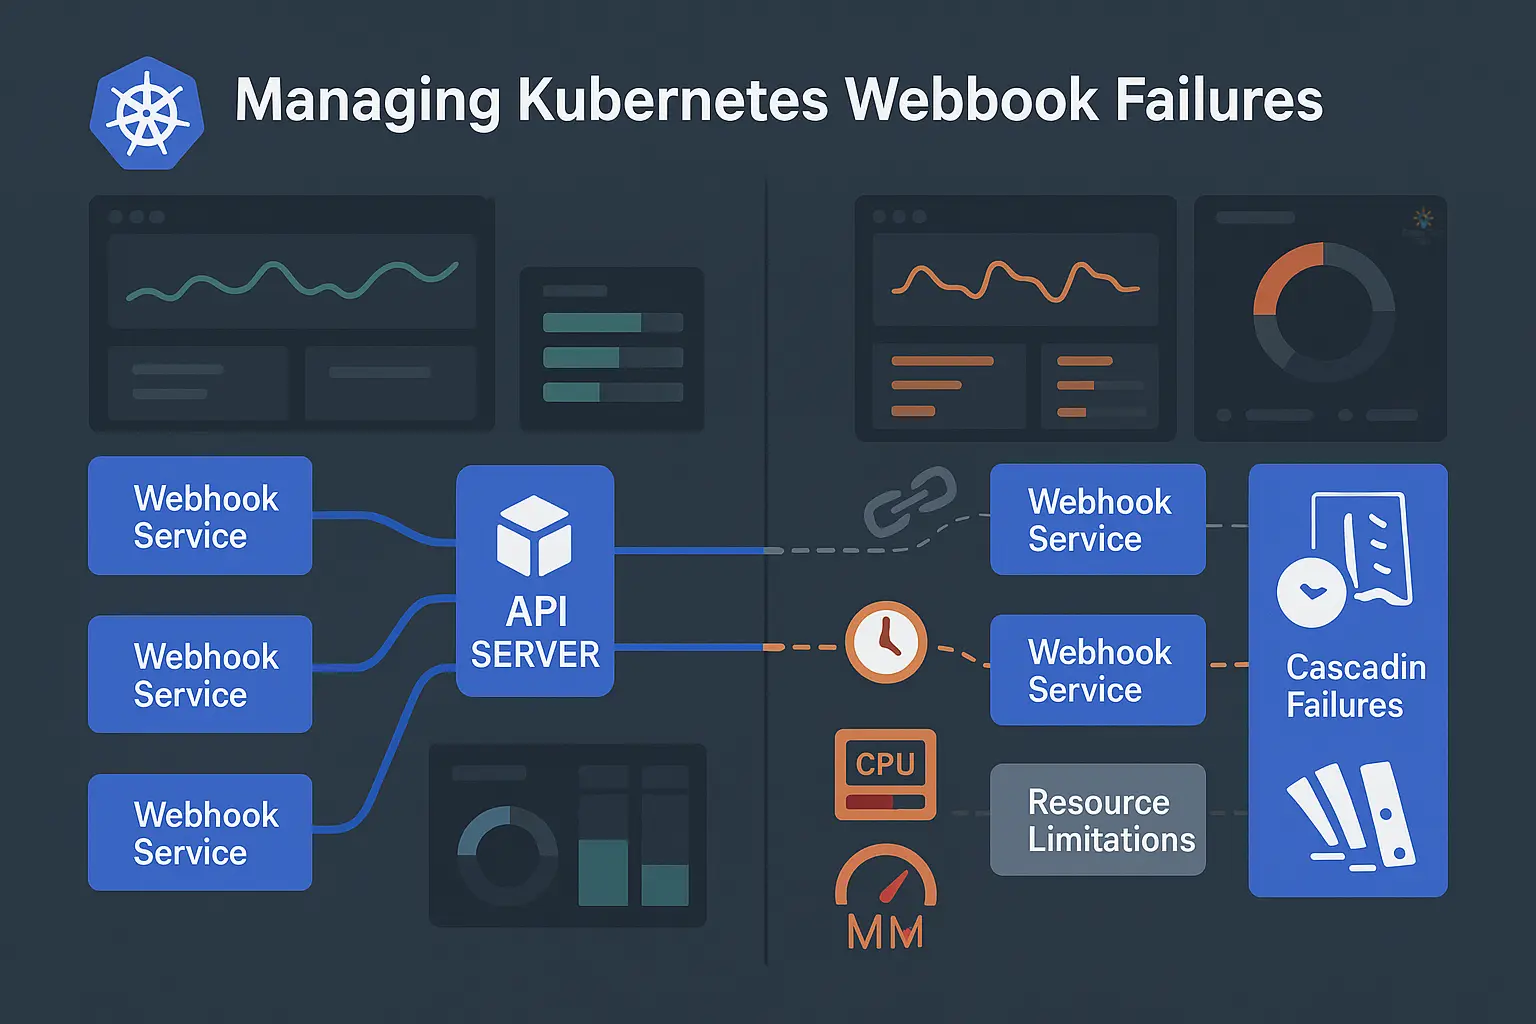
管理 Kubernetes Webhook 故障:从诊断到解决方案
在现代云原生架构中,Kubernetes Admission Webhook 扮演着至关重要的角色,允许我们扩展和自定义 Kubernetes 的行为,而无需修改核心代码。然而,这种强大的功能也带来了潜在的风险 — 当 webhook 发生故障时,可能会对整个集群造成严重影响,甚至导致系统性的服务中断。
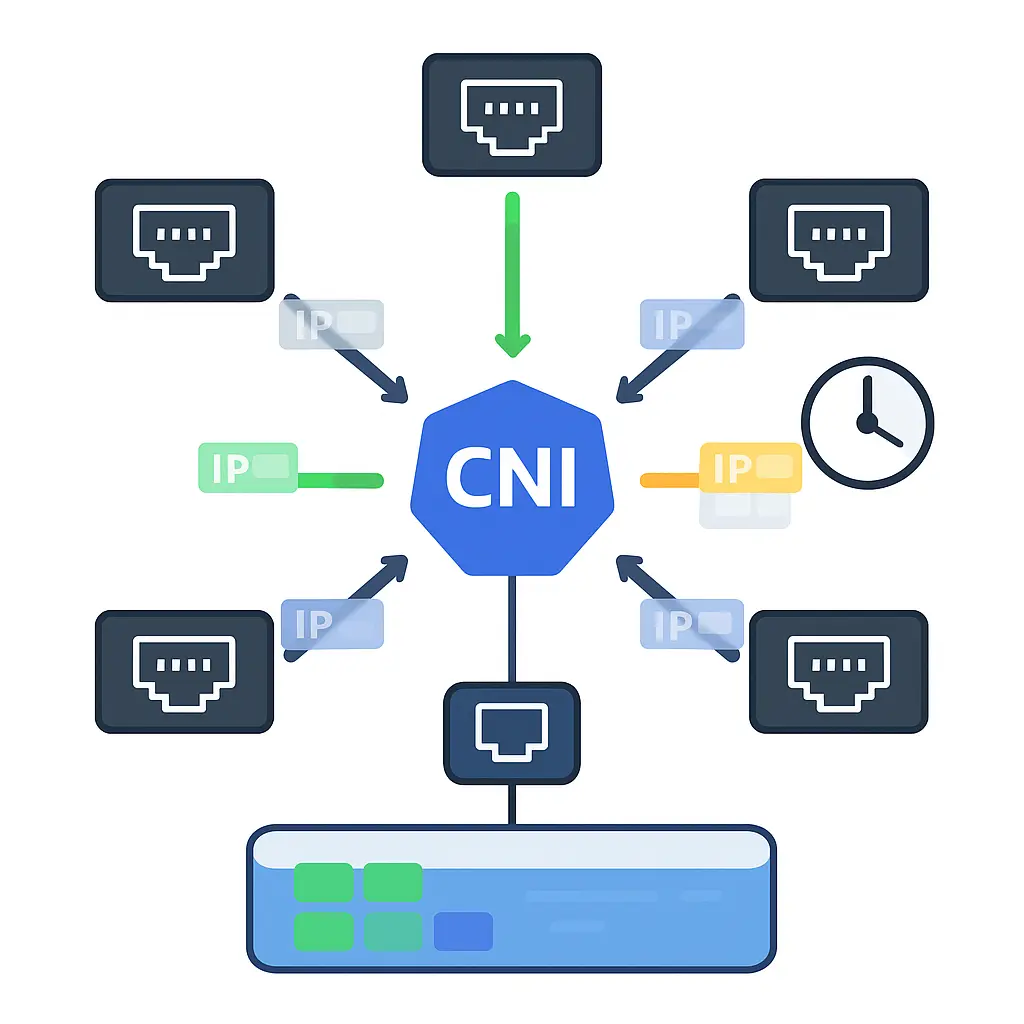
深入解析 Amazon EKS CNI 插件在快速扩缩过程中的 IP 分配难题
试想这样一个场景:一个看似普通的星期五下午,生产环境突然爆出严重事故,背后牵出一连串复杂的 IP 分配失败,甚至足以把整个 Kubernetes 集群拖进故障。这篇文章会深入拆解 CNI 插件配置里那些容易被忽略的风险,还原一次几乎演变成灾难的扩缩事件,并整理出避免 IP 耗尽的实战建议。接下来我会带你一起看清 failed to assign an IP address...
AWS Taipei 区域 (ap-east-2) 正式启用:完整启用指南与成本分析
2025 年对于台湾云端产业而言是历史性的一年,AWS 正式在台北启用全新的数据中心 (ap-east-2),三大公有云皆齐聚一堂。这不仅象征着台湾在全球云端版图的重要地位,更为在地企业带来前所未有的数字转型契机。通过本地化的云端基础设施,企业可享受毫秒级的延迟优化、完整的数据主权保护,以及更具竞争力的运营成本。本文将深入剖析 AWS Asia Pacific (Taipei) 区域的核心优势、提供完整的启用实作指南,并进行详细的跨区域成本分析,帮助您充分发挥这项新服务的价值。
利用 AWS 自动诊断工具简化 EBS CSI Driver 故障排除流程
在现代 Kubernetes 环境中,持久性存储是有状态 (Stateful) 应用程序的重要组件。Amazon EKS 用户通常会使用 Amazon EBS Container Storage Interface (CSI) 驱动程序来为应用程序提供持久性存储空间 (使用...