NCCL 是什么?多 GPU 训练的通信、调优与故障排查入门 | GPU 调试系列 #2
多张 GPU 一起训练同一个模型时,需要不断交换数据。NCCL 就是 NVIDIA GPU 训练中常用的通信库。本文围绕四个问题展开:NCCL 负责什么、它如何选择传输路径、怎样验证性能,以及训练变慢或卡住时该从哪里查起。
NCCL 是什么
以同步数据并行训练为例:每张 GPU 保存一份模型副本,一个批次的数据被拆分给不同 GPU,各自计算梯度,也就是用于更新模型参数的数值。由于每张 GPU 处理的数据不同,计算出的梯度也不同。如果直接各自更新参数,这些模型副本就会逐渐偏离。因此,训练框架需要先同步梯度,再让各个副本按同样的规则更新参数。
同步梯度通常会用到 AllReduce(全归约):先对所有参与 GPU 上的数据执行归约,再让每张 GPU 都得到相同的结果。常见做法是求和后再除以参与者数量,得到平均梯度;AllReduce 本身并不一定执行平均,具体取决于归约操作和框架的缩放方式。大模型训练还可能采用张量并行、流水线并行或参数分片,它们所需的通信操作和模式各不相同。1
NCCL(NVIDIA Collective Communications Library,NVIDIA 集合通信库)提供了一整套 GPU 通信操作。除了 AllReduce,还有 Broadcast(将一个参与者的数据广播给其他参与者)、AllGather(收集所有参与者的数据,拼接后让每个参与者都拿到完整结果)和 ReduceScatter(归约后,将结果的不同分片分发给各个参与者)等。使用 PyTorch 的 torch.distributed、DeepSpeed、Megatron-LM 或 JAX 在 NVIDIA GPU 上进行分布式训练时,底层通信都可能用到 NCCL。2
NCCL 的价值在于把通信细节封装起来。初始化时,它会检测 GPU、NVLink、PCIe 和网卡之间的连接关系,结合硬件拓扑、消息大小和运行配置选择传输路径、通信算法与协议。这样,应用程序通常不必自行实现数据如何在 GPU 之间传输的细节。不过,自动选择的效果仍取决于硬件、驱动和网络配置,需要通过测试确认。3
为什么要关注这些细节?因为 GPU 等待通信时,可能无法继续执行依赖通信结果的计算。通信对训练速度的影响取决于模型、并行策略、消息大小,以及计算与通信能否重叠。排查也有难度:某个节点或链路出现问题,可能导致多个进程超时,而最先报错的进程未必就是故障源。
数据传输路径
理解 NCCL,可以先区分两类通信:同一台服务器内的节点内通信,以及不同服务器之间的跨节点通信。它们依赖的硬件不同,带宽和延迟也不同。
- 节点内。 以 DGX H100 为例,8 张 H100 SXM GPU 通过 NVLink 和 NVSwitch 互联,每张 GPU 的 NVLink 双向总带宽最高为 900 GB/s,即每个方向最高为 450 GB/s。这是这类系统的硬件规格,不代表任意一对 GPU 或一次 AllReduce 都能达到 900 GB/s。在使用 NVLink/NVSwitch 的节点内 AllReduce 中,数据通常无需经过外部网卡。其他 H100 服务器可能采用不同的 GPU 数量、形态和互联方式。4
- 跨节点。 GPU 之间的数据需要通过网卡传输。DGX H100 配备 8 个用于计算网络的单端口 ConnectX-7 适配器,单端口速率最高为 400 Gb/s,支持 InfiniBand 或以太网;以太网上可以使用 RoCE(RDMA over Converged Ethernet)。具体采用哪种网络,取决于集群的基础设施和配置。注意,网卡规格中的 Gb/s 是吉比特每秒,GPU 带宽中的 GB/s 是吉字节每秒;400 Gb/s 换算为 50 GB/s,实际应用吞吐量还会受到协议开销等因素影响。4
在具备相应 PCIe 拓扑并启用 GPUDirect RDMA 的系统上,一条典型的跨节点数据路径如下:
GPU 显存 → PCIe 交换芯片 → 网卡 → 集群网络 → 对端网卡 → 对端 PCIe 交换芯片 → 对端 GPU 显存
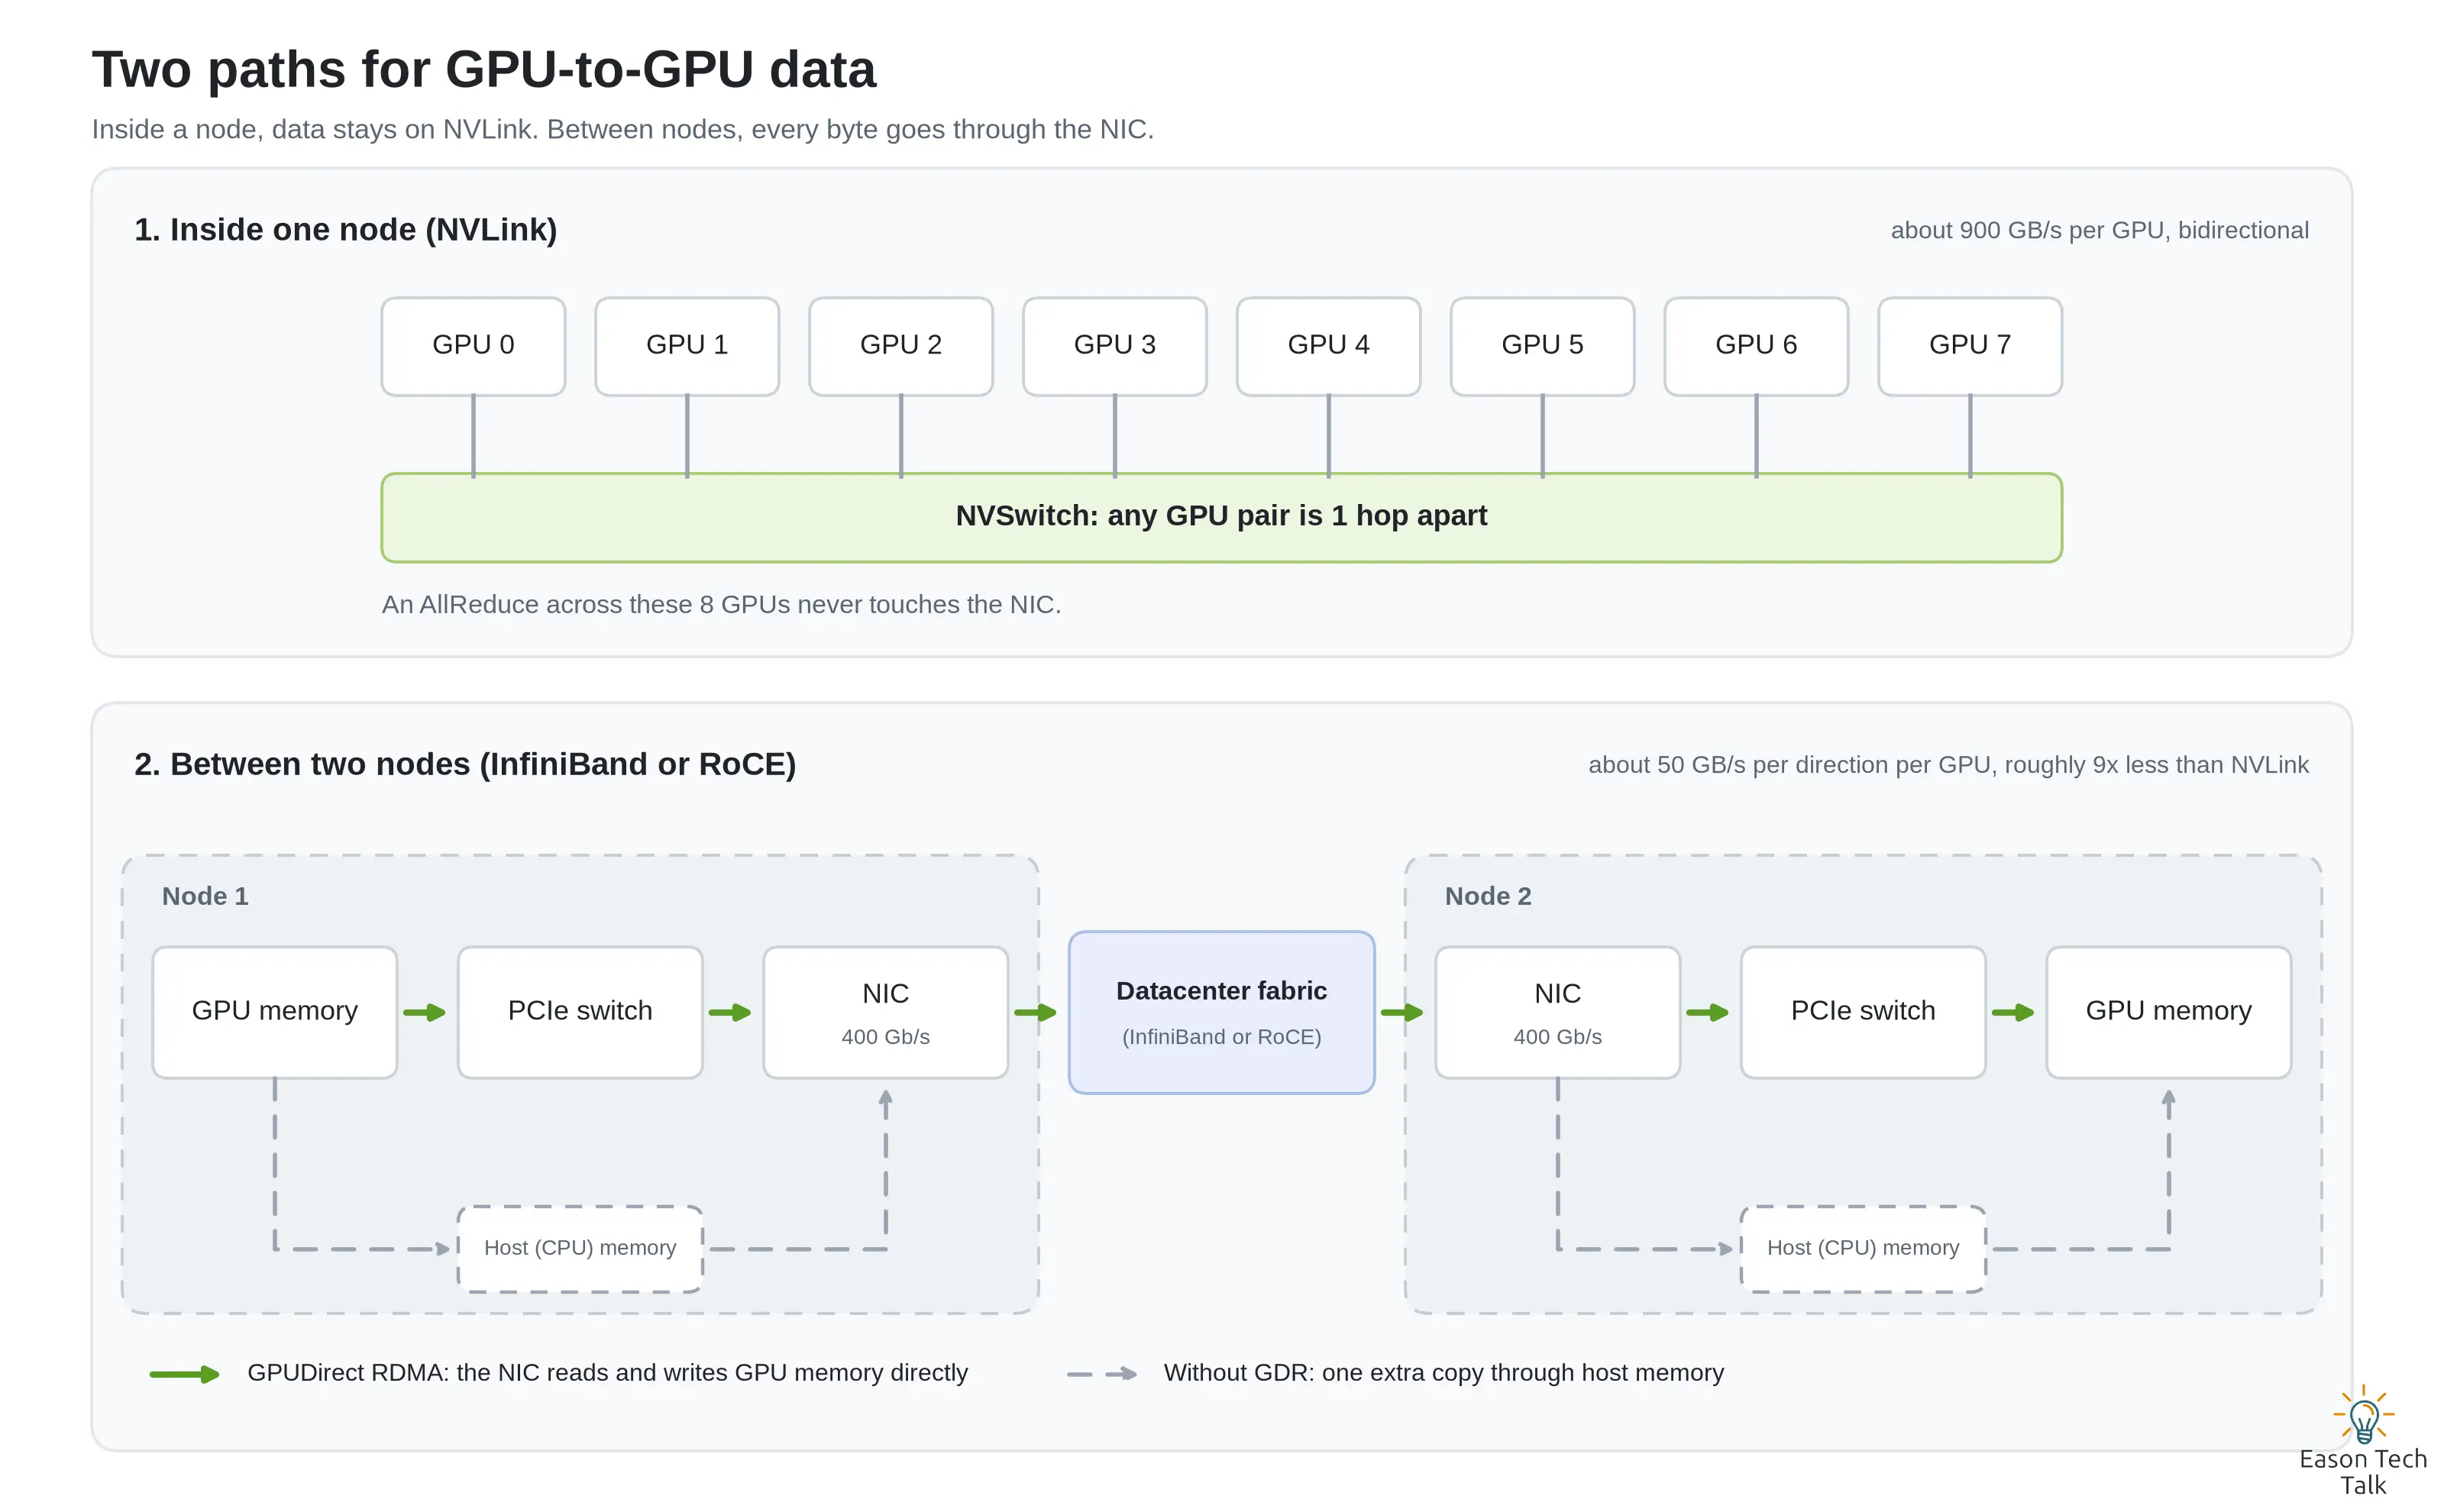
图中以 8 GPU 的 NVSwitch 系统为例。节点内通过 NVLink 和 NVSwitch 通信,跨节点通过 PCIe 和网卡传输;虚线表示未使用 GPUDirect RDMA 时经主机内存中转的路径。实际路径取决于服务器拓扑和 NCCL 的选择。
- GPUDirect RDMA(GDR)。 允许网卡直接访问 GPU 显存,减少经主机内存中转的复制和 CPU 开销。它能否生效,以及能带来多大的性能收益,取决于驱动、硬件拓扑和系统配置。5
- 丢包与拥塞。 丢包、重传和拥塞会增加通信延迟,也可能让训练中的其他参与者等待。RoCE 网络通常需要结合设备和部署方案配置拥塞控制与流量控制,例如 ECN(显式拥塞通知)和 PFC(基于优先级的流量控制)。PFC 用于减少特定优先级流量的丢包,ECN 用于反馈拥塞,二者的作用不同。不能仅凭启用了 PFC 或 ECN 就认定网络已经配置正确。6
NCCL 如何选择传输路径和算法
NCCL 会根据检测到的拓扑、可用的通信后端和运行配置,为通信选择路径和算法。把这两层分开看,日志就更容易理解。
选择传输路径。 节点内可以使用基于 NVLink 或 PCIe 的 GPU 点对点访问,也可以在需要时通过共享主机内存中转。跨节点通常使用 InfiniBand 或 RoCE 上的 RDMA;如果 RDMA 后端不可用,某些配置下可能会使用 Socket/TCP 后端,也可能直接初始化失败。TCP 与 RDMA 的性能差距取决于硬件和工作负载。排查时应确认实际使用的后端是否符合预期。5 7
选择通信算法。 同样一次 AllReduce,可以通过不同的方式组织数据传递。以下是几种常见算法,并非 NCCL 支持的完整列表。8 7
| 算法 | 如何工作 | 通常适用的场景 |
|---|---|---|
| Ring(环形) | 将 GPU 组织成环。典型的 Ring AllReduce 先执行 ReduceScatter,逐步归约数据并让各参与者保留一个结果分片;再执行 AllGather,让所有参与者拿到完整结果 | 大消息的带宽利用率通常较好,常用于梯度同步 |
| Tree(树形) | 沿树形结构归约,再将结果分发出去;NCCL 的树形实现会进一步并行组织传输 | 通常有利于降低通信延迟,适合小消息或较多参与者的场景 |
| NVLS(NVLink SHARP) | 使用支持该功能的 NVSwitch 执行部分归约计算,将通信中的部分工作卸载到互联硬件 | 具有相应 NVSwitch 硬件和软件支持的系统,例如 DGX H100 |
NCCL 从 2.17 版本开始支持 NVLS;该功能需要支持它的硬件(例如 DGX H100 中的 Hopper GPU 和第三代 NVSwitch),以及 CUDA 12.1 或更高版本和兼容驱动。NVLS 可以提高兼容系统上的集合通信性能,但收益取决于消息大小、数据类型、软件版本和硬件配置。应以目标系统上的测试结果为准;算法能够启用,也不意味着它对每一种消息大小都最快。9 10
性能测试:nccl-tests
判断集群通信是否正常、调优是否有效,可以先运行 NVIDIA 的 nccl-tests。它会测试集合通信的正确性与性能,帮助你把通信问题与模型计算、数据加载等因素分开。下面是一个单进程、8 GPU 的 AllReduce 测试:11
git clone https://github.com/NVIDIA/nccl-tests.git
cd nccl-tests

# 需要 C++ 编译器、CUDA 开发环境以及 NCCL 头文件和库
# 如果 NCCL 安装在非默认路径,可额外设置 NCCL_HOME
make CUDA_HOME=/usr/local/cuda

# 单进程使用 8 张 GPU,消息大小从 8 字节递增至 8 GiB
./build/all_reduce_perf -b 8 -e 8G -f 2 -g 8
这里的 8G 表示每张 GPU 上最大 8 GiB 的消息,测试缓冲区还需要额外显存;如果显存不足,应调小 -e。
跨节点测试需要在构建时启用 MPI 支持,例如 make MPI=1 CUDA_HOME=/usr/local/cuda,并准备相应的 MPI 开发环境。运行时使用 MPI 启动器指定主机和进程布局。上面的单机命令只验证节点内通信;跨节点网络性能需要通过多机测试单独验证。
阅读测试结果时,重点关注耗时、正确性检查,以及这两个带宽指标:
algbw(算法带宽): 按操作的数据大小除以耗时计算。busbw(总线带宽): 根据集合操作的通信量模型对algbw进行归一化。对于有n个参与者的 AllReduce,busbw = algbw × 2 × (n - 1) / n。它便于比较不同规模的通信效率,但不是硬件链路计数器测得的实际流量,也不能不加区分地与网卡或 NVLink 的标称带宽直接比较。12
对比结果时,应尽量保持 GPU 数量、拓扑、消息大小、数据类型、进程布局和软件版本一致,再与同配置系统的基线比较。
基础故障排查
unhandled system error 等错误通常不足以定位问题,需要查看 NCCL 日志中的具体告警和上下文。排查时可以临时启用 INFO 级别日志,并为每台主机上的每个进程分别保存日志:5 7
# %h 会替换为主机名,%p 会替换为进程 ID
NCCL_DEBUG=INFO NCCL_DEBUG_FILE=/tmp/nccl.%h.%p.log python train.py

# 平时运行时,仅输出警告和错误
NCCL_DEBUG=WARN python train.py
如果使用 torchrun 或其他启动器,将上面的 python train.py 替换为实际启动命令,并确保相关环境变量传递到所有节点上的进程。
日志中有三个值得优先关注的地方:
- 最早出现的相关告警。 从第一个有意义的
WARN及其前后文查起,再关联其他进程的日志。后续错误可能是连带反应,但第一条告警也不一定就是根因。 - 选中了哪张网卡。 区分用于初始化连接的 Bootstrap 接口与承载 GPU 数据的通信后端。Bootstrap 使用
eth0,并不意味着集合通信也走 TCP。 - 实际使用的传输路径。
NET/IB通常表示 NCCL 的 RDMA 后端,既可能用于 InfiniBand,也可能用于 RoCE;NET/Socket表示 Socket 后端。有些版本会用GDRDMA标识某条连接使用了 GPUDirect RDMA,但日志格式会随 NCCL 版本和网络插件变化,不能仅凭缺少这一后缀就断定 GDR 未生效。13
下面是便于理解的日志示意,并非某个版本的完整实际输出。具体字段和格式以你的运行环境为准。
第一种:跨节点使用 RoCE,所列连接出现了表明 GPUDirect RDMA 生效的标识。
NCCL INFO Bootstrap : Using eth0:10.0.0.11<0>
NCCL INFO NET/IB : Using [0]mlx5_0:1/RoCE
NCCL INFO Using network IB
NCCL INFO Channel 00/04 : 0 1 2 3
NCCL INFO Channel 00/04 :    0[0] -> 1[0] via NET/IB/0/GDRDMA
NCCL INFO Channel 00/04 :    1[0] -> 2[0] via NET/IB/0/GDRDMA
NCCL INFO Channel 00/04 :    2[0] -> 3[0] via NET/IB/0/GDRDMA
NCCL INFO Connected all rings
第二种:使用 Socket/TCP 后端。如果原本预期使用 RDMA,就应检查 RDMA 设备是否对容器可见、驱动与用户态库是否可用,以及是否有配置禁用了 RDMA。网络拥塞或 RoCE 配置错误也可能导致任务超时或失败,并不一定会触发自动回退到 TCP。
NCCL INFO NET/IB : No device found.
NCCL INFO NET/Socket : Using [0]eth0:10.0.0.11<0>
NCCL INFO Using network Socket
NCCL INFO Channel 00/04 :    0[0] -> 1[0] via NET/Socket/0
NCCL INFO Channel 00/04 :    1[0] -> 2[0] via NET/Socket/0
NCCL INFO Connected all rings
常见错误与检查方向
同一条错误信息可能对应多种原因。下面列出的是排查起点,需要结合具体日志判断。5 14
| 现象 | 可能的原因 | 优先检查 |
|---|---|---|
unhandled system error |
系统调用或外部库调用失败,例如共享内存不足、锁页内存限制或 RDMA 资源创建失败 | 阅读具体 WARN;如果日志指向 /dev/shm,可增大 Docker 的 --shm-size,或在 Kubernetes 中将内存型 emptyDir 挂载到 /dev/shm;同时检查容器中的 RDMA 设备和内存锁定限制 |
unhandled cuda error |
CUDA 调用失败,例如驱动兼容性、GPU 状态或之前的异步 CUDA 错误 | 查看具体 CUDA 错误及更早的日志,检查驱动与 CUDA 的兼容性,并排查程序或 GPU 故障 |
| 运行过程中超时 | 某个参与者没有及时进入或完成通信:可能是进程异常退出、硬件问题、死锁,或各 rank 调用的集合操作顺序不一致 | 检查所有 rank 的日志、系统日志和 GPU 状态;确认集合操作的顺序、参与者以及数据数量和类型一致 |
| RDMA 超时或重试次数超限 | 网络拥塞、路由或链路问题,也可能与线缆、光模块、交换机有关 | 用 ibstat 查看 InfiniBand 端口状态,结合 perfquery 或交换机遥测检查计数器;RoCE 可结合 ethtool -S 和 rdma statistic 查看统计信息;用 ib_write_bw 等点对点测试缩小范围,确认原因后再评估 NCCL_IB_TIMEOUT |
| 没有报错,但通信明显偏慢 | 后端或网卡选择不符合预期、GDR 未生效、拓扑限制或网络拥塞 | 运行 nccl-tests,与相同配置的基线比较;检查日志中的后端、网卡和 GDR 相关信息 |
是否使用 /dev/shm 取决于 NCCL 版本和配置;较新版本在满足条件时也可能采用 cuMem 主机内存分配。因此,只有日志指向共享内存资源时,才应优先沿这一方向排查。
在 PyTorch 中,TORCH_NCCL_ASYNC_ERROR_HANDLING 控制 ProcessGroupNCCL 的异步错误处理行为。设为 1 时,监控线程检测到错误后会中止通信器并终止进程。它用于处理故障后的退出行为,定位原因仍需要检查各 rank 的日志。具体含义与默认值应以所用 PyTorch 版本的文档为准。15
总结
NCCL 为多 GPU 训练提供集合通信能力,并根据可用硬件组织数据传输。理解它时,可以先抓住三点:AllReduce 等操作在做什么,数据如何在节点内和节点间流动,以及如何用 nccl-tests 和日志验证实际行为。
遇到训练变慢或卡住,先确认通信后端、网卡和传输路径是否符合预期,再结合性能基线与各进程日志缩小范围。这样能更清楚地区分通信配置、硬件网络和训练程序本身的问题。
附录:术语速查
| 术语 | 通俗解释 |
|---|---|
| NCCL | NVIDIA 集合通信库,负责 GPU 之间的数据通信,并选择传输路径、算法和协议。 |
| AllReduce(全归约) | 对所有参与者的数据执行求和等归约操作,并让每个参与者得到完整结果。同步平均梯度时,还需要按框架约定进行缩放。 |
| NVLink / NVSwitch | NVIDIA 的 GPU 高速互联技术与相应的交换芯片,用于构建 GPU 之间的高速连接。 |
| GPUDirect RDMA(GDR) | 允许网卡直接访问 GPU 显存,减少经主机内存中转的复制。 |
| RoCE | 在以太网上实现 RDMA 的协议。部署时需要关注拥塞和丢包,并按网络方案配置 ECN、PFC 等机制。 |
| HCA | Host Channel Adapter,主机通道适配器;在这里通常指支持 InfiniBand 或 RoCE 的 RDMA 网卡,设备名可能是 mlx5_0。 |
| Ring / Tree / NVLS | NCCL 中常见的通信算法:环形传输、树形归约与分发,以及利用 NVSwitch 进行归约卸载。 |
| busbw | nccl-tests 根据集合操作的通信量模型,从算法带宽换算出的归一化带宽指标;不是直接测得的物理链路流量。 |
| rank | 通信参与者在组内的编号。在常见的一进程一 GPU 训练方式中,一个 rank 对应一个进程和一张 GPU。 |
参考资料