NCCL 是什麼?多 GPU 訓練的通訊、調校與排查入門 | GPU 除錯系列 #2
What Is NCCL? Multi-GPU Communication, Tuning, and Debugging
多顆 GPU 一起訓練同一個模型時,它們之間必須不停交換資料,負責這件事的軟體就是 NCCL。這篇用白話講四件事:NCCL 到底在做什麼、它怎麼決定資料走哪條線、哪些設定真的值得調,以及訓練變慢或卡住時該從哪裡查起。
NCCL 是什麼
訓練一個大語言模型時,同一批資料會被切成幾份分給不同 GPU,每顆卡用自己那一份算出一組梯度,也就是參數該往哪個方向調整的數值。問題是每顆卡看到的資料不一樣,算出來的梯度也不一樣,如果各自更新,跑幾步就會變成好幾個不同的模型。所以在更新參數之前,所有卡得先把手上的梯度交出來、加總平均,再把同一份結果收回去。這個動作叫 AllReduce,是分散式訓練裡最常出現、也最花時間的通訊。
NCCL(NVIDIA Collective Communications Library)就是 NVIDIA 寫來做這件事的函式庫。它提供一整套「一群 GPU 同時交換資料」的操作,除了 AllReduce,還有 Broadcast(一顆卡發給所有人)、AllGather(每顆卡的資料大家都收一份)等等。你在 PyTorch 裡用 torch.distributed,或是用 DeepSpeed、Megatron-LM、JAX,底層都可能有 NCCL 從中協調。1
NCCL 幫你省掉的麻煩是:你不用自己決定資料走哪條線。它啟動時會掃描這台機器有哪些通訊管道(GPU 之間的 NVLink、主機板上的 PCIe、對外的 InfiniBand 或乙太網路),再自動挑一條最快的路和最合適的傳法。
為什麼要在意這個?因為通訊控制的優劣能直接決定 GPU 有多少時間真的在算。在一台調校良好的 8 卡 H100 機器上,通訊大約佔每個訓練步驟 20% 到 30% 的時間;設定沒弄好時會吃掉 40% 到 50%,等於你買的 GPU 有一半時間在等資料。2更麻煩的是這類問題很難查:只要一條線降速,幾百張卡的任務就會集體超時(timeout),而且報錯的那張卡通常不是真正有問題的那張。
資料傳輸路徑
GPU 叢集的資料傳輸可以類比成公司裡的溝通:同一間辦公室的同事轉頭就能講到,跨辦公室得走外線,速度差一個量級。GPU 之間也只有這兩種路,先分清楚資料走的是哪一種,才看得懂 NCCL 在做什麼。
- 機器裡面。 一台 H100 伺服器的標準配置是 8 顆 GPU,彼此用 NVLink 相連,每顆卡的雙向頻寬合計 900 GB/s。這些連線再匯到 NVSwitch 晶片上,所以任兩顆卡之間都只隔一跳、距離一樣遠。同一台機器內的 8 卡 AllReduce,資料從頭到尾不會碰到網卡。
- 機器之間。 只能走網卡。H100 的標準機型會為每顆 GPU 配一張 400Gb/s 的 ConnectX-7 網卡,可以跑 InfiniBand,也可以跑 RoCE(在乙太網路上做 RDMA),兩種 NCCL 都支援,選哪一種通常取決於機房既有的架構。跨機時資料的完整路徑大概是這樣:
GPU 記憶體 → PCIe switch → 網卡 → 機房網路 → 對方網卡 → 對方 PCIe switch → 對方 GPU 記憶體
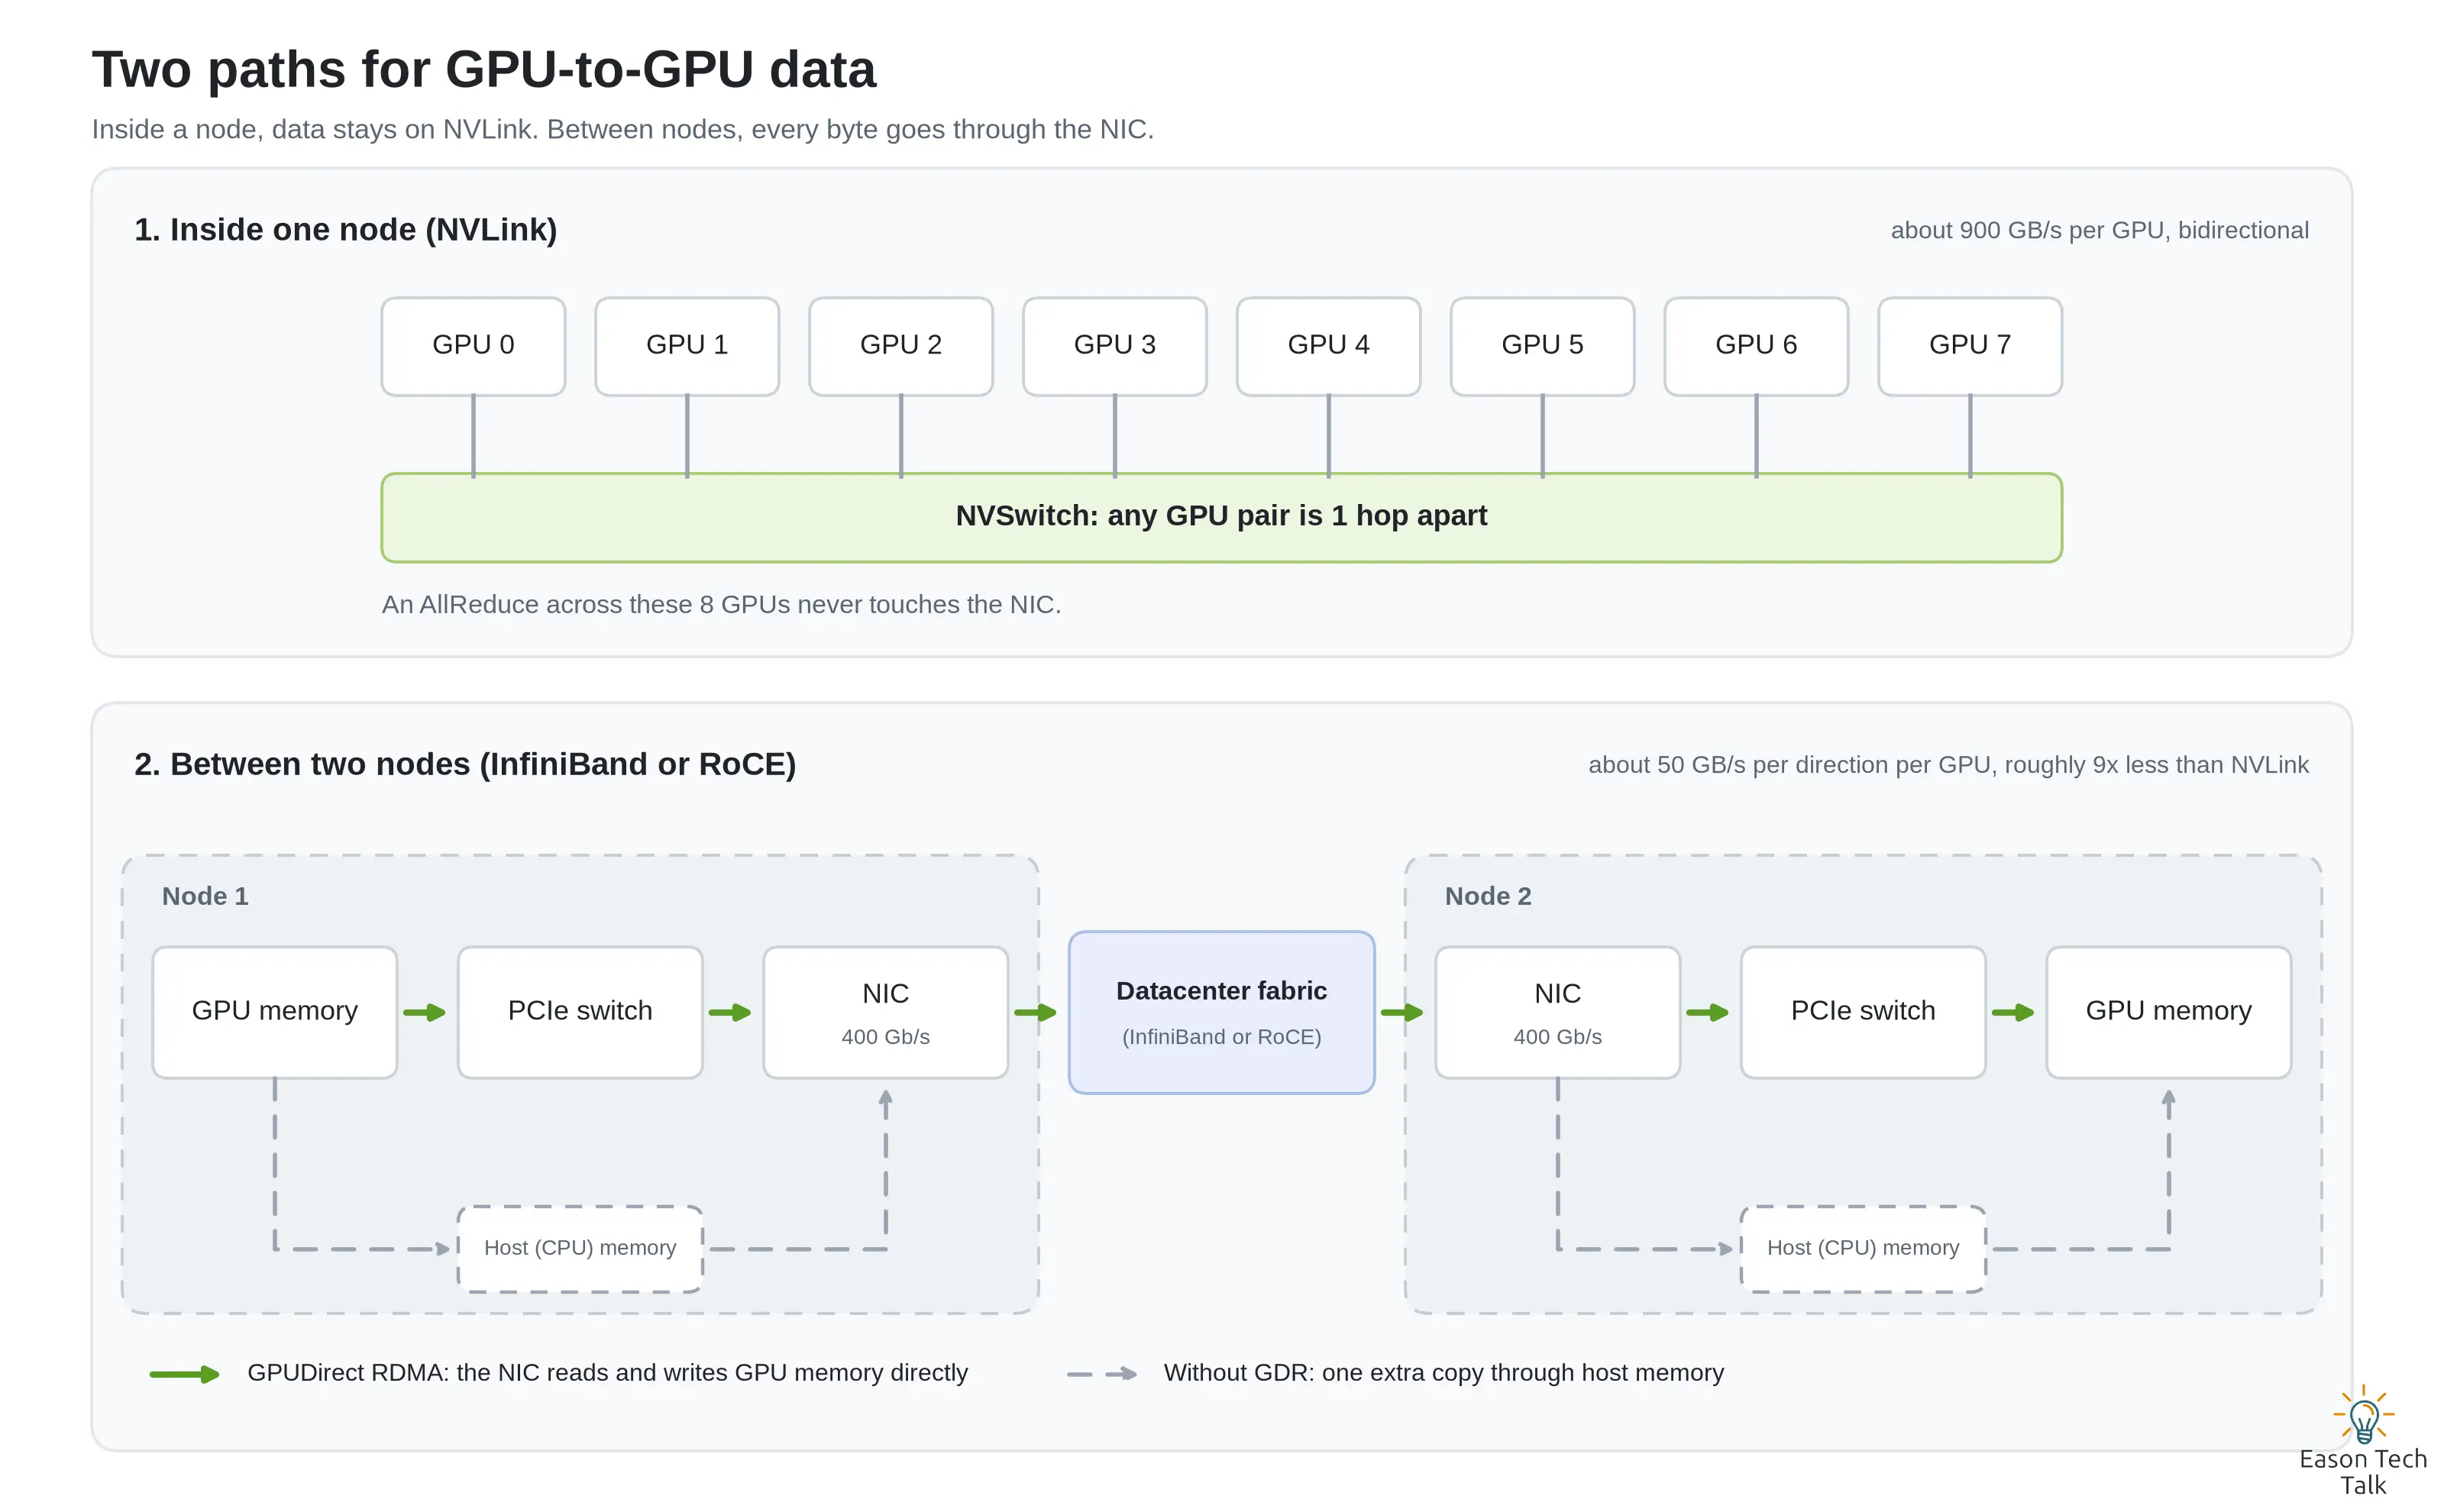
機器內的 8 卡靠 NVSwitch 互通;跨機時每一筆資料都得經過 PCIe switch 和網卡。虛線是沒開 GPUDirect RDMA 時多出來的那一次主機記憶體複製。
- GPUDirect RDMA(常簡稱 GDR):讓網卡直接讀寫 GPU 記憶體,不用先把資料搬到 CPU 的記憶體再轉一手,啟用後能讓提高大資料量的跨機頻寬。3
- 丟包:RDMA 網路對丟包極度敏感。因為 AllReduce 是同步的,一個封包晚到,其他所有卡都得等。實測上 0.1% 的丟包率就可能讓 GPU 使用率掉一成以上,1% 幾乎等於整個任務癱掉。4這也是為什麼用 RoCE 的機房一定要先把無損網路的流量控制(PFC、ECN)設定調好。
NCCL 怎麼決定資料走哪條路
NCCL 啟動時會先畫出一張它看到的拓撲圖,然後做兩個決定:走哪條線,還有用什麼隊形。
走哪條線。 機器內優先用 NVLink,沒有 NVLink 就退到 PCIe,再不行就經過主機記憶體。機器之間優先用 RDMA,如果找不到 RDMA 硬體或設定不對,就退回普通的 TCP,速度差十倍以上。除錯時很重要的一件事,就是確認 NCCL 沒有默默退到慢的那條路。2
用什麼隊形。 同一份資料要在幾十顆卡之間彙總,傳遞的順序有好幾種設計5:
| 隊形 | 怎麼運作 | 適合的場合 |
|---|---|---|
| Ring(環狀接力) | 所有 GPU 圍成一圈,每顆卡同時把一小塊資料交給右邊的鄰居,繞完一圈就彙總完成,所有線路全程都在用 | 資料量大的時候,也就是同步梯度最常見的情況 |
| Tree(樹狀) | 像組織圖一樣往上彙總、再往下發布,經過的跳數少 | 卡數很多但每次傳的資料很小 |
| NVLS | 直接請 NVSwitch 晶片順手把加法做掉,GPU 之間因此少傳一輪資料 | H100 之後的機型,單機多卡 |
NVLS 是 H100 世代比較有感的改進:在 DGX H100 上開啟之後(需要 NCCL 2.17 以上、CUDA 12.1 以上),8 卡 AllReduce 大約可以從 370 GB/s 提升到 480 GB/s。5
效能測試:nccl-tests
要判斷叢集健康或調校有沒有效,標準做法是跑 nccl-tests6:
git clone https://github.com/NVIDIA/nccl-tests.git
cd nccl-tests && make MPI=1 CUDA_HOME=/usr/local/cuda

# 單機 8 卡,資料量從 8 bytes 一路測到 8 GB
./build/all_reduce_perf -b 8 -e 8G -f 2 -g 8
簡易問題除錯
NCCL 的錯誤訊息(例如 unhandled system error)本身幾乎不含線索,真正的資訊在 debug log 裡3 7:
NCCL_DEBUG=INFO python train.py        # 查問題時
NCCL_DEBUG=WARN                        # 正式跑的時候只記錯誤,不洗版
NCCL_DEBUG_FILE=/tmp/nccl.%h.%p.log    # 每個主機、每個 process 各一個檔案
log 有三個地方要看:
- 第一行
WARN。那通常就是根本原因,後面一長串錯誤多半是連帶反應。 - 挑到哪張網路介面
- 實際走了哪條路。初始化的 log 會逐一列出每個通道是走 NVLink、共享記憶體還是網路;跨機的那幾行如果結尾是
via NET/IB/0/GDRDMA,表示 GPUDirect RDMA 有生效,只寫到via NET/IB/0就是沒吃到。
下面為日誌中可能會看到的例子。
第一種:跨機走 InfiniBand/RoCE,且 GPUDirect RDMA 有生效(通常會看到 NET/IB + GDRDMA)。例如:
NCCL INFO Bootstrap : Using eth0:10.0.0.11<0>
NCCL INFO NET/IB : Using [0]mlx5_0:1/RoCE
NCCL INFO Using network IB
NCCL INFO Channel 00/04 : 0 1 2 3
NCCL INFO Channel 00/04 :    0[0] -> 1[0] via NET/IB/0/GDRDMA
NCCL INFO Channel 00/04 :    1[0] -> 2[0] via NET/IB/0/GDRDMA
NCCL INFO Channel 00/04 :    2[0] -> 3[0] via NET/IB/0/GDRDMA
NCCL INFO Connected all rings
第二種:看起來也「能跑」,但其實 RDMA 沒用上、退回 Socket/TCP(常見原因是 RDMA 裝置沒掛進容器、權限/驅動不對、或 RoCE 無損沒配好導致初始化失敗)。log 常會出現 NET/Socket 或類似的警告,例如:
NCCL WARN NET/IB : No device found.
NCCL WARN NET/IB : Failed to init IB verbs, falling back to Socket
NCCL INFO NET/Socket : Using [0]eth0:10.0.0.11<0>
NCCL INFO Using network Socket
NCCL INFO Channel 00/04 :    0[0] -> 1[0] via NET/Socket/0
NCCL INFO Channel 00/04 :    1[0] -> 2[0] via NET/Socket/0
NCCL INFO Connected all rings
常見錯誤和該往哪查
| 遇到的狀況 | 最常見的原因 | 先查什麼 |
|---|---|---|
unhandled system error |
容器的共享記憶體不夠(NCCL 用 /dev/shm 做機內通訊),或 RDMA 相關呼叫失敗 |
Docker 加 --ipc=host 或加大 --shm-size;Kubernetes 掛一個記憶體型的 emptyDir 到 /dev/shm;確認 ibstat 正常 |
unhandled cuda error |
驅動、CUDA 與框架的版本對不上 | 看 log 裡的 WARN 訊息,把驅動和 CUDA 版本對齊 |
| 跑到一半整個 timeout | 有某張卡掉隊:硬體降速、死鎖,或不同 rank 呼叫通訊的順序不一致 | 開 TORCH_NCCL_ASYNC_ERROR_HANDLING=1 讓錯誤浮出來;確認所有 rank 呼叫的通訊順序一致 |
| RDMA 的 timeout 或 retry 超限 | 網路壅塞,或線材、光模組、交換器有問題 | ibstat 看連線狀態和錯誤計數;大叢集可調高 NCCL_IB_TIMEOUT;用 ib_write_bw 做點對點測試找出壞掉的那一段 |
| 沒報錯,但就是特別慢 | 走到慢的路了:退回 TCP、GDR 沒開、挑錯網卡 | 跑 nccl-tests 對照參考值;看 log 裡的路徑選擇和相關紀錄排查 |
總結
這篇從 AllReduce 出發,說明 NCCL 在多 GPU 訓練裡負責什麼,接著看資料在機器內走 NVLink、跨機走 RDMA(InfiniBand 或 RoCE)的路徑差異,以及 NCCL 如何挑選傳輸路徑與 Ring/Tree/NVLS 隊形;最後是用 nccl-tests 驗證效能,還有從 NCCL_DEBUG 的 log 判讀常見問題。多 GPU 訓練變慢或卡住時,先確認 NCCL 有沒有挑到對的那條路,通常就能找到答案。
附錄:名詞小抄
| 名詞 | 白話解釋 |
|---|---|
| NCCL | NVIDIA 的集體通訊函式庫,負責多 GPU 之間交換資料並自動挑選傳輸路徑與演算法。 |
| AllReduce | 所有 GPU 交出手上的數字、彙總之後每個人都拿到同一份結果,訓練時用來平均梯度。 |
| NVLink / NVSwitch | 同一台機器裡 GPU 之間的高速連線與交換器。 |
| GPUDirect RDMA(GDR) | 網卡直接讀寫 GPU 記憶體,不繞道 CPU 記憶體。 |
| RoCE | 在乙太網路上跑 RDMA 的協定,對丟包敏感,需要搭配 PFC/ECN 等無損設定。 |
| HCA | InfiniBand 或 RoCE 網卡的正式名稱,裝置名通常長得像 mlx5_0。 |
| Ring / Tree / NVLS | NCCL 的三種通訊隊形:環狀接力、樹狀彙總、交換器代算(NVSwitch 網內計算)。 |
| busbw | nccl-tests 報告的線路實際流量,可以直接跟硬體規格比較。 |
| rank | 分散式訓練裡每個參與 process 的編號,通常一個 rank 對應一顆 GPU。 |
參考資料