NCCL 是什麼?多 GPU 訓練的通訊、調校與排查入門 | GPU 除錯系列 #2
What Is NCCL? Multi-GPU Communication, Tuning, and Debugging
讀懂 NVIDIA Xid 錯誤碼:GPU 除錯的第一堂課 | GPU 除錯系列 #1
本文寫給還沒接觸過 NVIDIA GPU 維運的讀者,從 Xid 是什麼、去哪裡找、怎麼讀開始,並以掉卡(Xid 79, GPU has fallen off the bus)與 ECC Error(Xid...
AI 超級電腦的高速公路:從 GB200/GB300 看懂 RDMA 網路
只要你大概知道「CPU、記憶體、網路」是什麼,就能從頭讀到尾。我們會從「為什麼 AI 需要網路」講起,一路深入到 NVIDIA GB200 / GB300 機櫃裡的三層網路架構,以及 RDMA 這項讓十萬顆 GPU 像一台電腦一樣工作的關鍵技術。
AI 時代的技術面試:一場正在被重寫規則的賽局
最近讀到 Coinbase 工程團隊發表的《Interviewing Engineers in the AI Era》,講他們如何花了一整年重建技術面試流程。1順著這條線,我把 Canva、Meta、Google、Datadog 等公司的最新做法與產業數據都翻了一遍,越看越確定一件事:當 AI 已經寫下 Coinbase 在 2025...
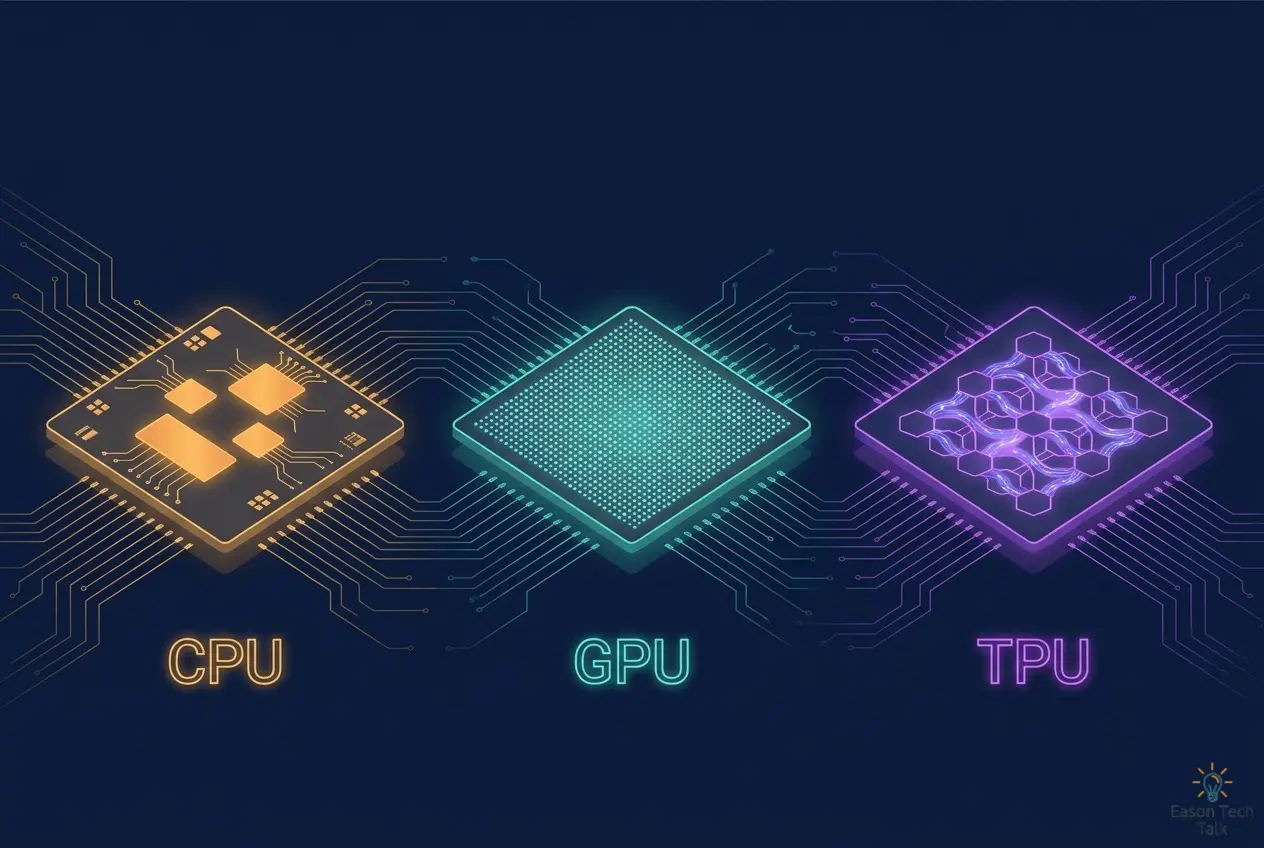
CPU、GPU、TPU 到底差在哪?新手也能看懂的晶片指南
一句話總結:CPU 是什麼都會的「萬能主廚」、GPU 是同時做上千道菜的「大型廚房軍團」、TPU 則是專門做一道菜、但做得又快又省電的「自動化中央廚房」。
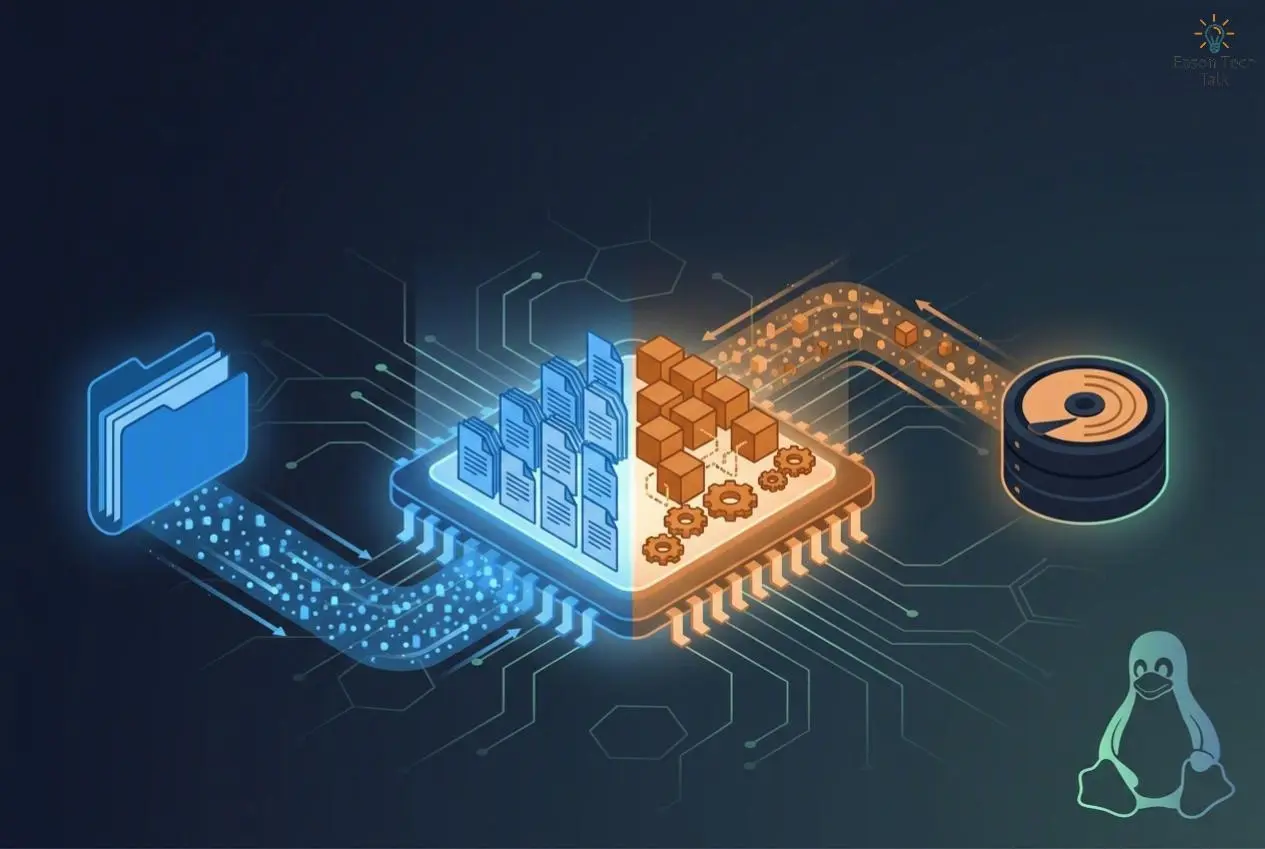
Linux 面試經典:buff 和 cache 到底差在哪?從 vmstat 看懂 Page Cache 與 Buffer
buff 和 cache 都是拿記憶體來暫存資料,那它們到底差在哪?「我的 free 記憶體怎麼只剩一點點,是不是系統快掛了?」
16 小時通過 NVIDIA NCA-AIIO:備考計畫與 7 大考試重點
我最近通過了 NVIDIA-Certified Associate: AI Infrastructure and Operations(NCA-AIIO) 認證考試。這篇文章將分享我的備考方法、考試重點整理,以及過程中發現值得深入研究的主題,讓你能更有效率地準備這項考試。
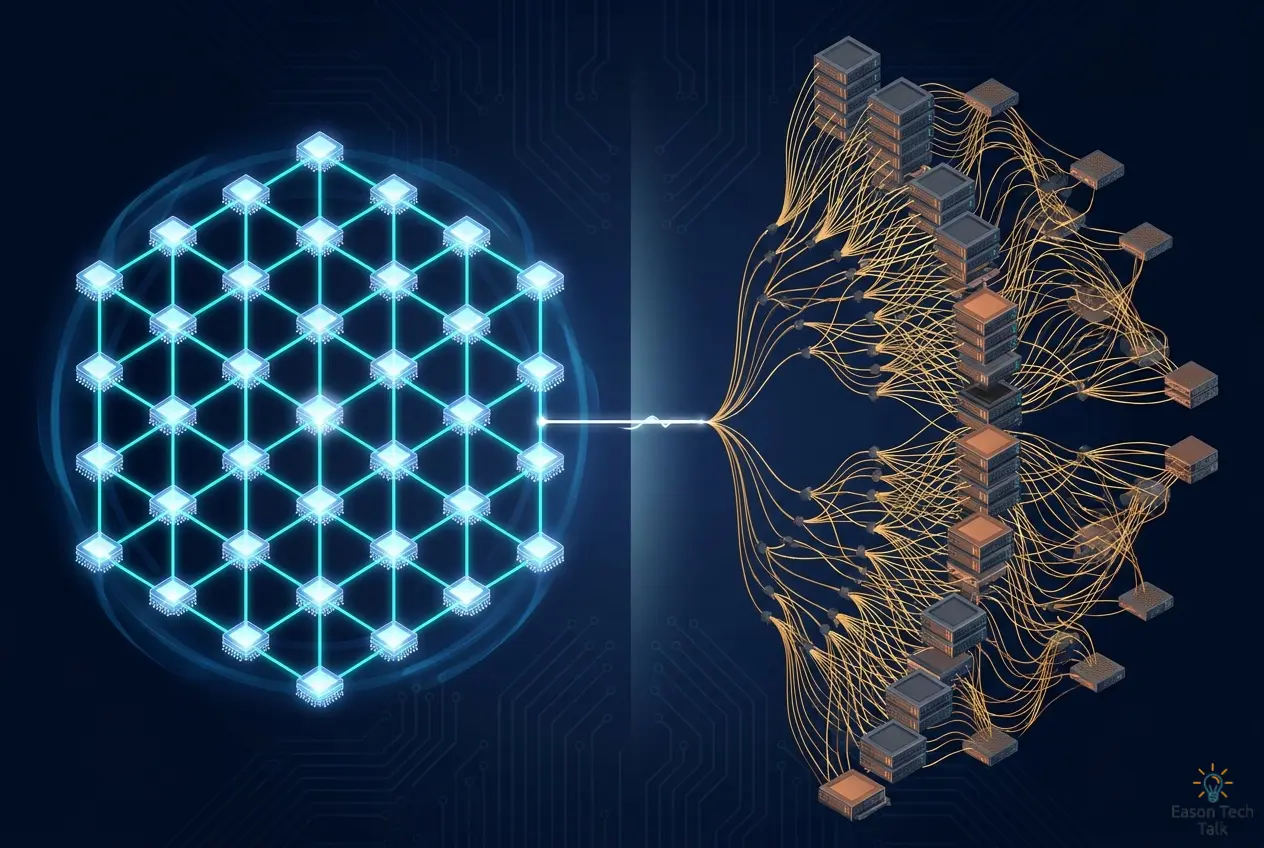
TPU 的 4x4x4 到底在乘什麼?一篇看懂 TPU Slice 與 GPU 設計哲學
一開始在學習 TPU 的架構時,我對於規格說明上切片 (slice) 是 4x4x4、8x16、16x16 這類的數字感到困惑……當下冒出一連串疑問:為什麼是「幾乘幾」?這些數字是矩陣乘法的維度嗎?為什麼 GPU 的世界好像不用管這些,TPU 卻要把拓撲搞得這麼複雜?
AI 有意識嗎?為什麼 ChatGPT 這麼好用卻常一本正經地出錯
最近跟周遭的人聊天,發現大家對 AI 的想像落差大得驚人:有人受電影影響,擔憂 AI 哪天會毀滅人類 (覺得它快要有意識了),有人覺得它只是高級一點的搜尋引擎或聊天機器人。本篇嘗試回答一個更為實際的問題:我們手上的 AI 究竟是什麼?它為什麼有時非常有用,又為什麼常在關鍵時刻很笨?
Oncall 心態指南:Dropbox 與 AWS 頂尖工程師的事故應對與 postmortem 心法
在前一篇 Pager 沒響卻聽見警報?Oncall 工程師的睡眠與焦慮指南 裡,那篇談的是 oncall 的代價與防禦,這篇想談談 oncall 的心態。我最近聽了兩個訪談,一篇是前 Dropbox 最資深工程師 James Cowling,另一篇則是 AWS Distinguished...
解決 GKE 升級卡住的隱形殺手:Admission Webhook
在管理 Google Kubernetes Engine (GKE) 叢集的日常中,定期升級版本是維持安全性、修補漏洞與取得新功能的必要工作。但實際上可能會在 Logs Explorer 裡看到讓人摸不著頭緒的錯誤訊息 (例如 Internal error 或 DeployPatch failed)1,升級流程就這樣卡住,遲遲無法完成。...
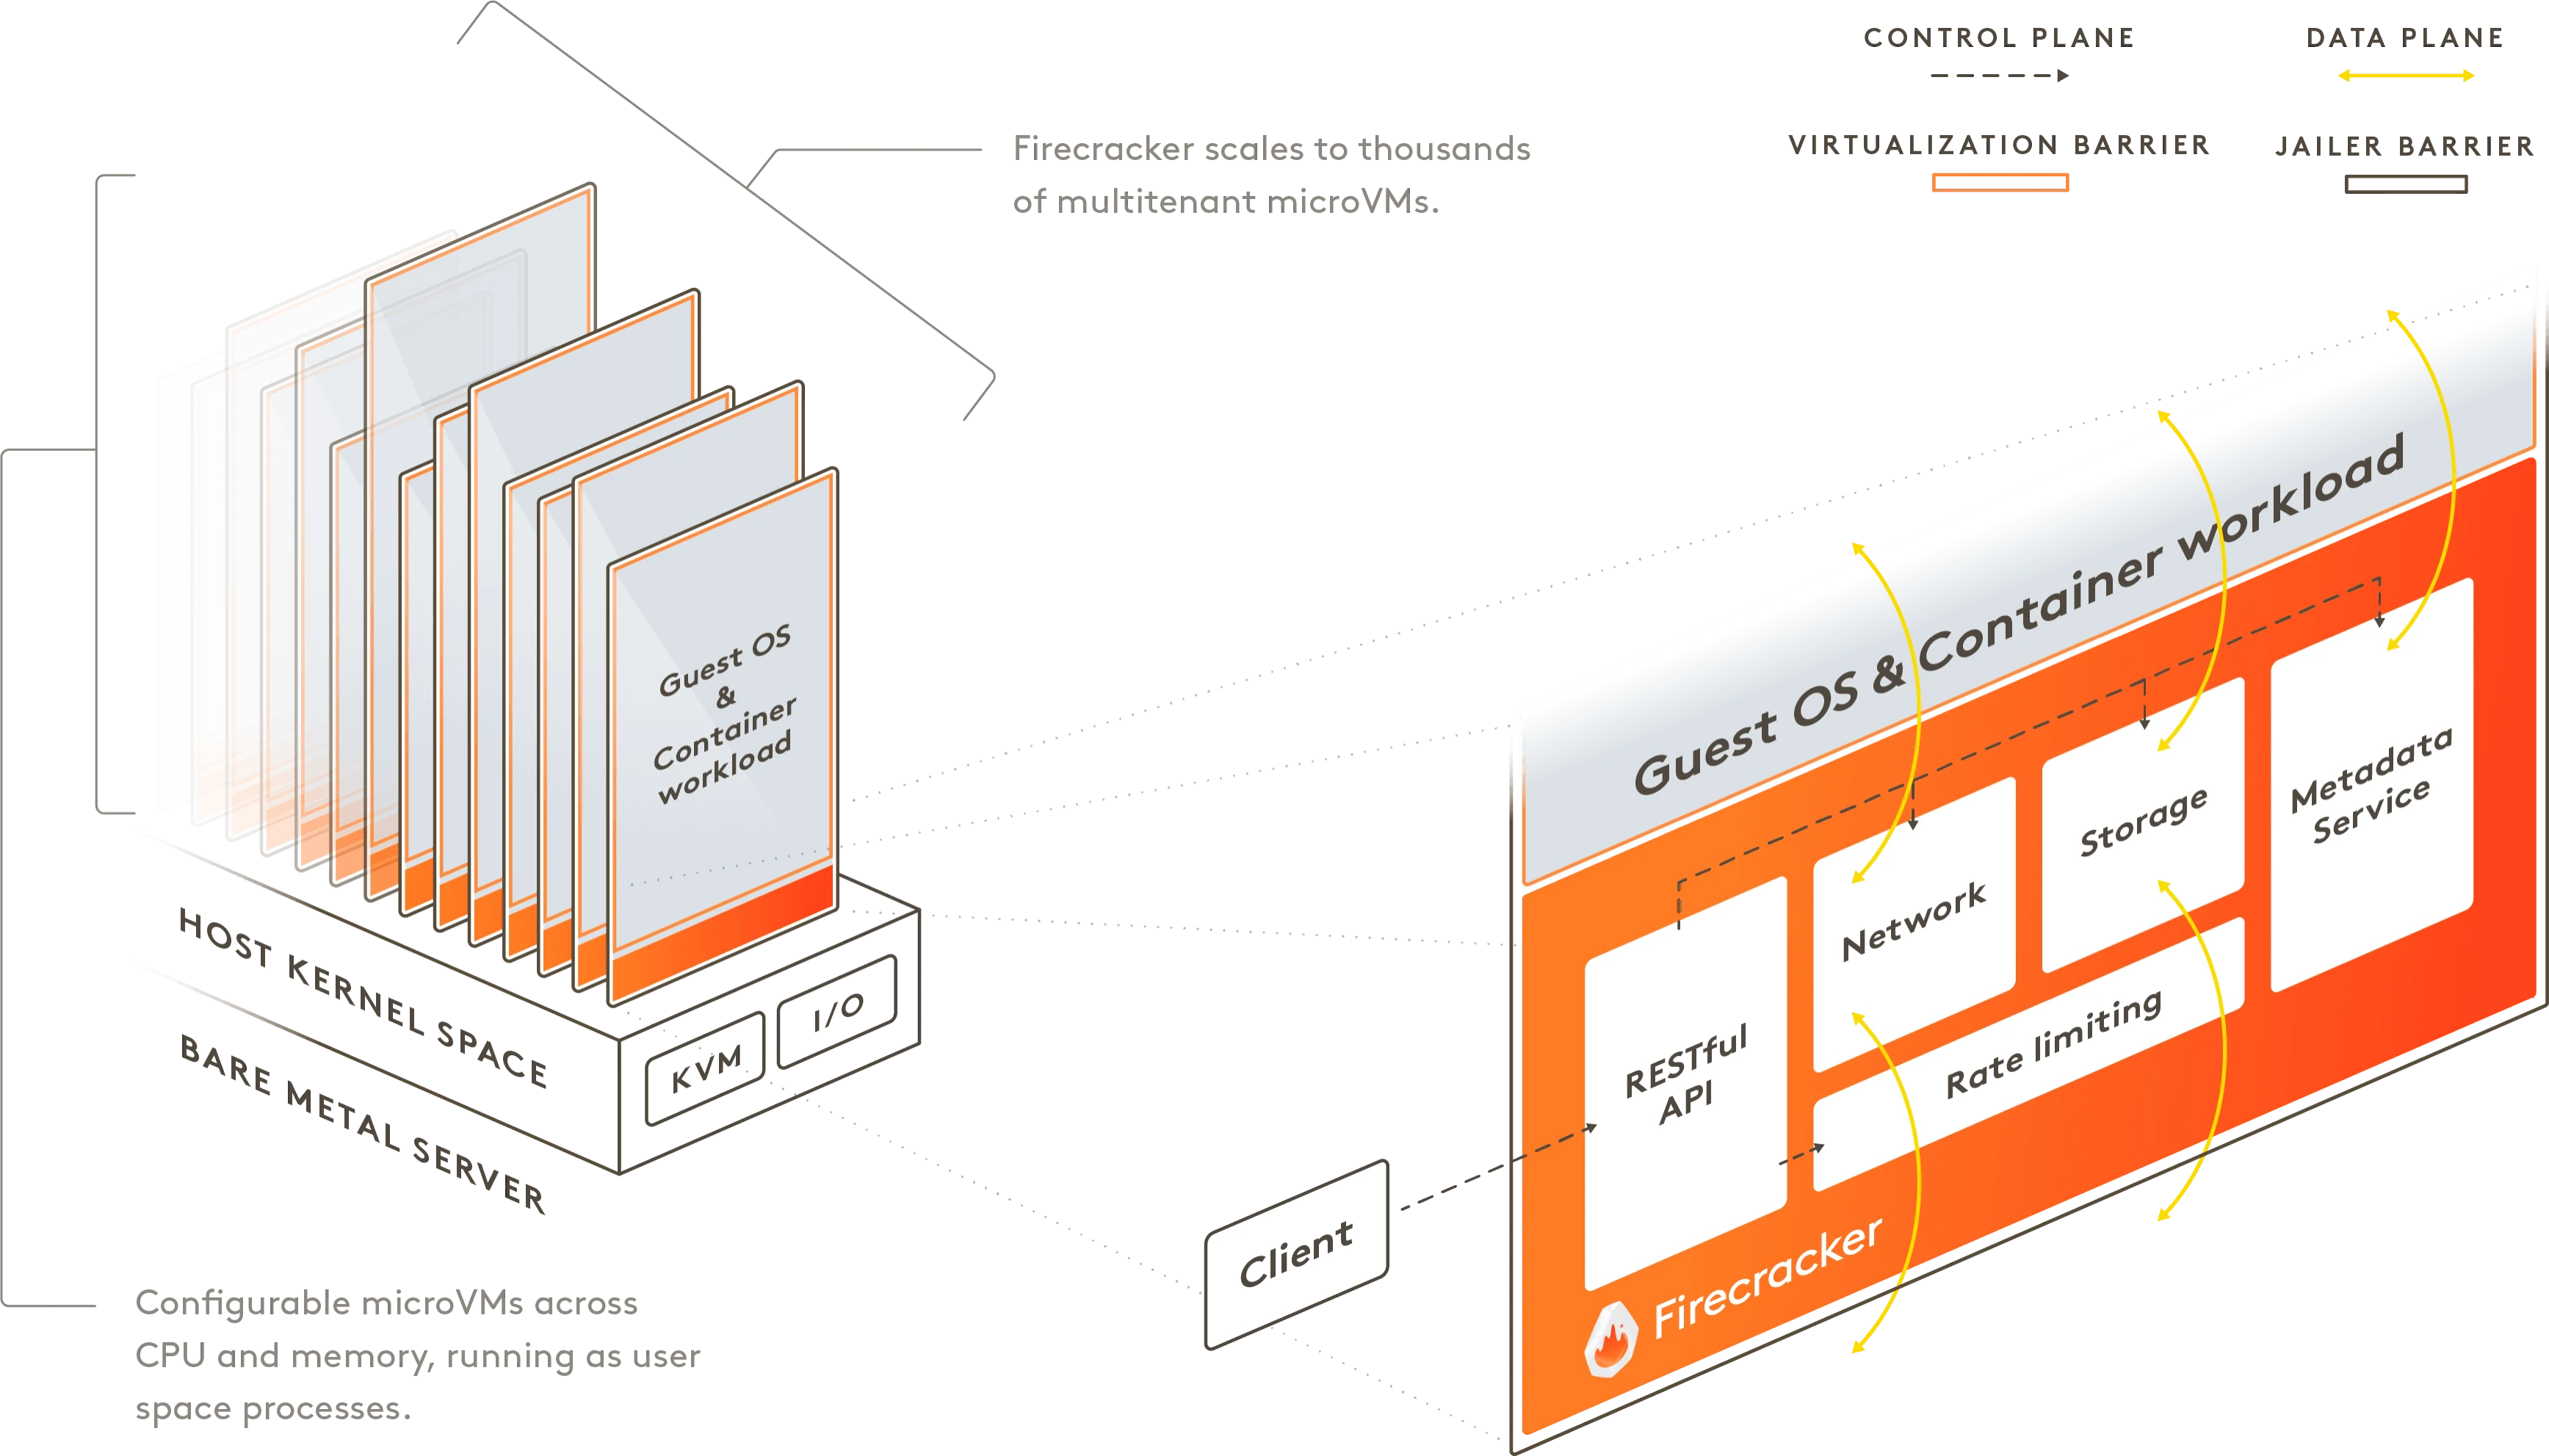
AWS Firecracker 論文導讀:AWS 為什麼用 microVM 支撐 Serverless
Firecracker 是 AWS 開源的 Virtual Machine Monitor,用來執行輕量級的 microVM。它最常被提到的原因,是 AWS Lambda 底層使用了這套技術:AWS 需要快速啟動隔離的執行環境,在大型主機上承載大量租戶,同時保留使用者對虛擬機隔離邊界的安全期待。
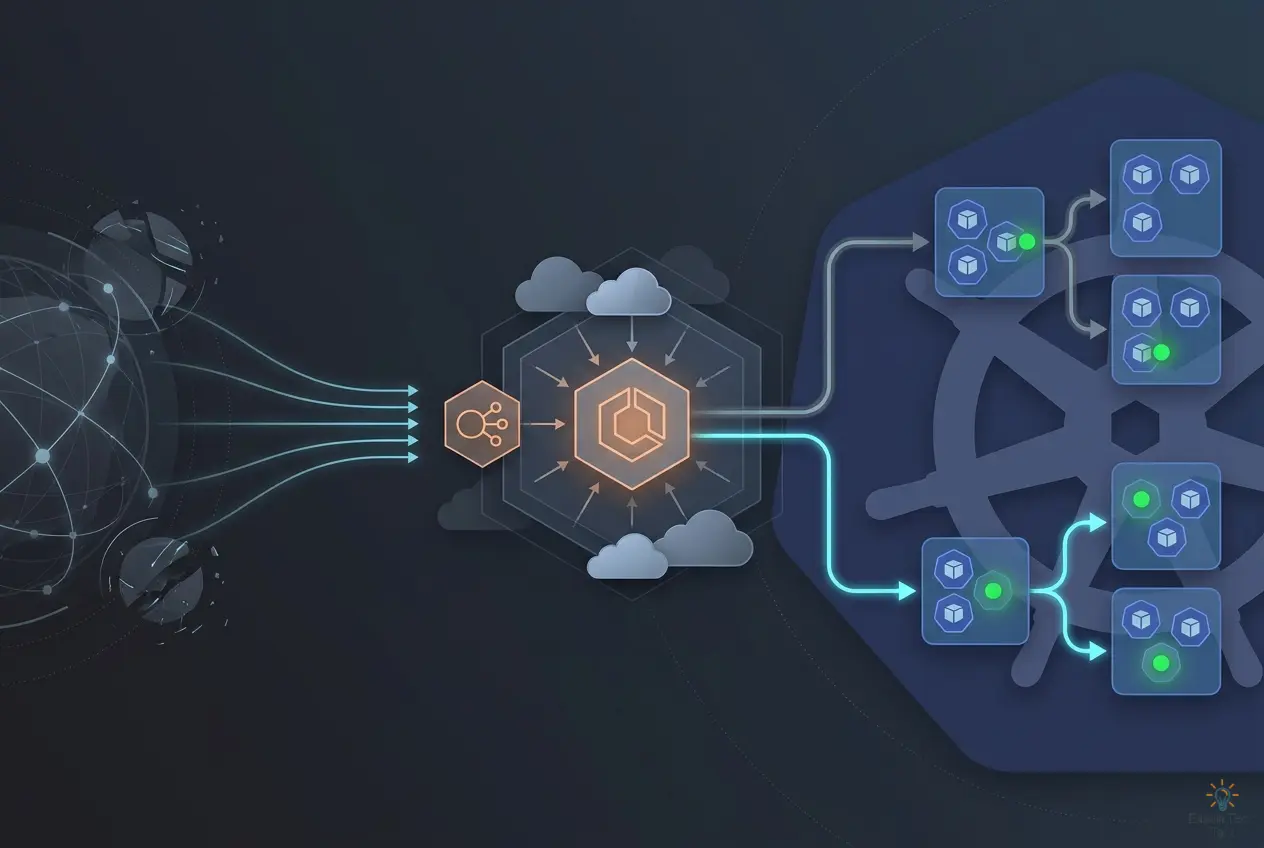
EKS Load Balancing 最佳實務:Service、NLB、ALB 與 IP Targets
在 Amazon EKS 上做 Load Balancing,看起來很簡單;但只要開始追一個 request 到底經過哪些節點、最後打到哪個 Pod,事情就會變複雜。
ChatGPT 越用越焦慮?AI 時代知識工作者的心理健康指南
「我同事用 AI 兩小時做完我整天的工作。我打開電腦,看著他在 Slack 上丟出來的成果,只覺得很累。」如果你也有類似的感覺,也許這篇文章能有所幫助。
Pager 沒響卻聽見警報?Oncall 工程師的睡眠與焦慮指南
身為要 Oncall 的工程師,下面這幾種狀況大概都不陌生:pager 沒響,腦海中卻隱約聽到警報,拿起手機才發現是錯覺;半夜被叫醒進客戶會議,腦袋還沒清醒就被要求回答問題;下班想閉眼放空 5 分鐘,腦袋反而比工作時更停不下來;oncall 都已經結束了,還是會無意識地點開值班時那些沒處理完的調查。
SkipYT:支援 BYOK 的 YouTube AI 摘要工具
今天推出 SkipYT:一個讓你貼上 YouTube 連結、幾秒內就能拿到結構化摘要與 Q&A 的 AI 工具。支援 BYOK(Bring Your Own Key)、預設繁中輸出。現在就可以用:skipyt.com
Kubernetes Megacluster 技術全景:各家大規模叢集如何突破萬節點天花板
Kubernetes 上游 SIG Scalability 定義了 5,000 nodes 的「建議上限」,但各大雲端廠商和科技公司早已在挑戰這個天花板。GKE 用 Spanner 替換 etcd 跑出 130K nodes、EKS...
EKS vs GKE:大規模 Kubernetes 叢集架構的效能深度比較 (100K+ 節點)
AI 訓練的爆發式成長,正在把 Kubernetes 叢集推向前所未有的規模。當單一訓練任務可能需要數萬張 GPU 同時協作,「一個叢集能撐多大」就不再是理論問題,而是真金白銀的基礎建設決策。
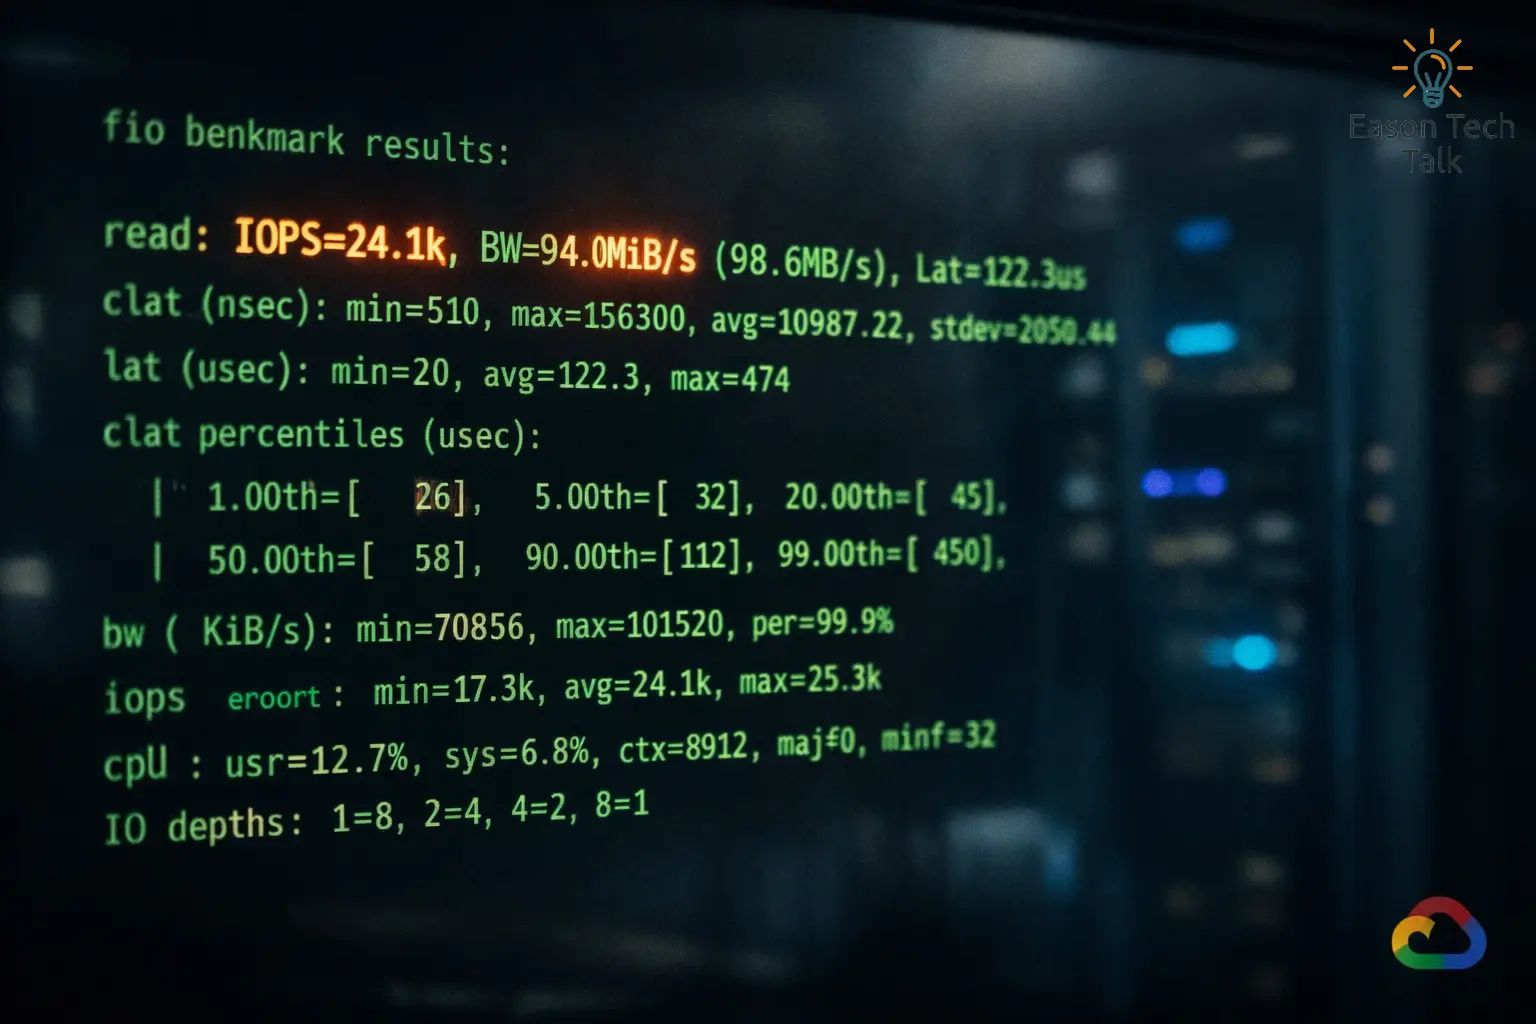
AI 訓練磁碟 I/O 瓶頸排查:從 fio Benchmark 到 GCP Hyperdisk 優化實踐
你有沒有遇過這種情況:在 GCP 上開了一台 VM,掛上 Hyperdisk Balanced,花錢買了 160,000 IOPS 的效能額度(provisioned IOPS)1,信心滿滿地跑了一輪 fio 壓測,結果 IOPS 只有少少的 ~2,000?...
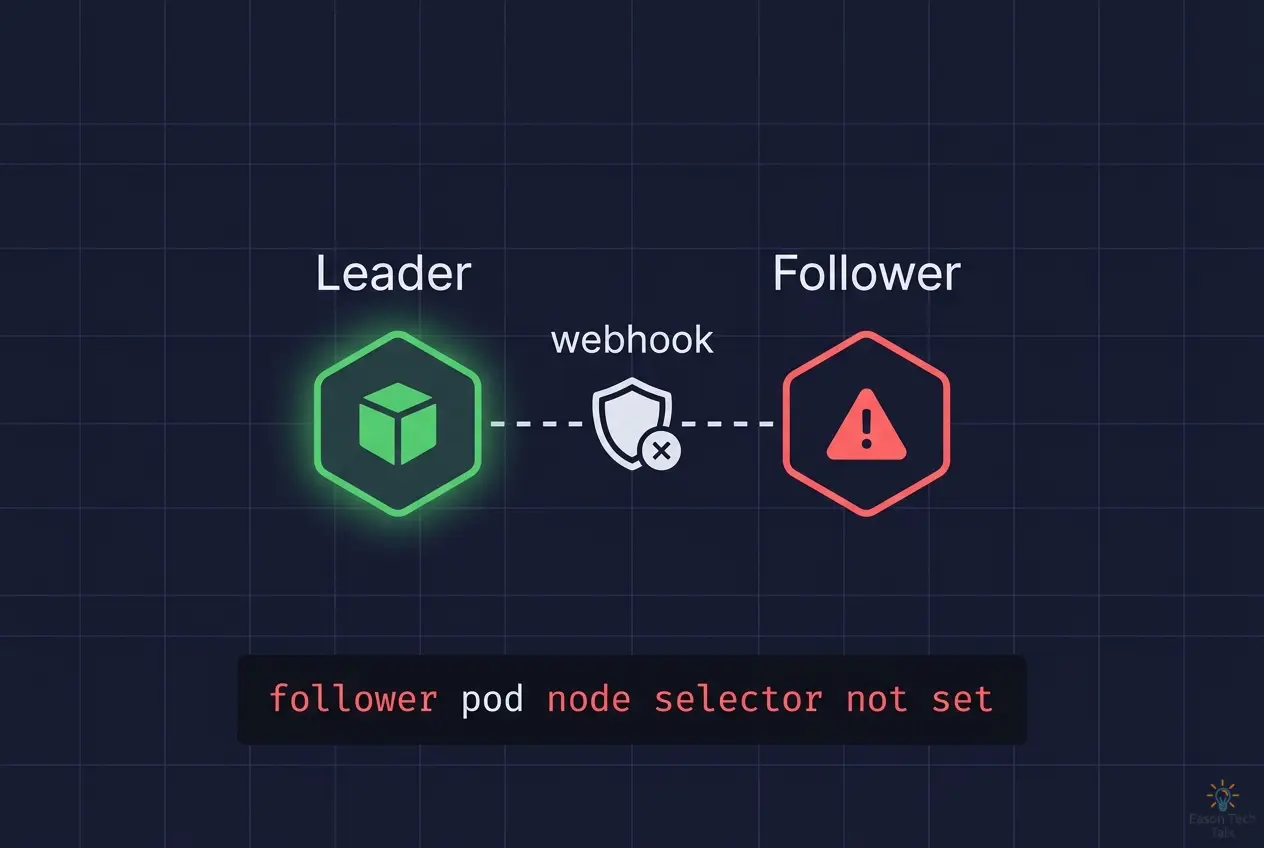
JobSet 排查實錄 (解決 follower pod node selector not set)
在用 JobSet 跑 multi-slice TPU 或 GPU 的分散式訓練時,JobSet 的 leader-follower 機制會先排程 leader pod,再透過 mutating webhook...
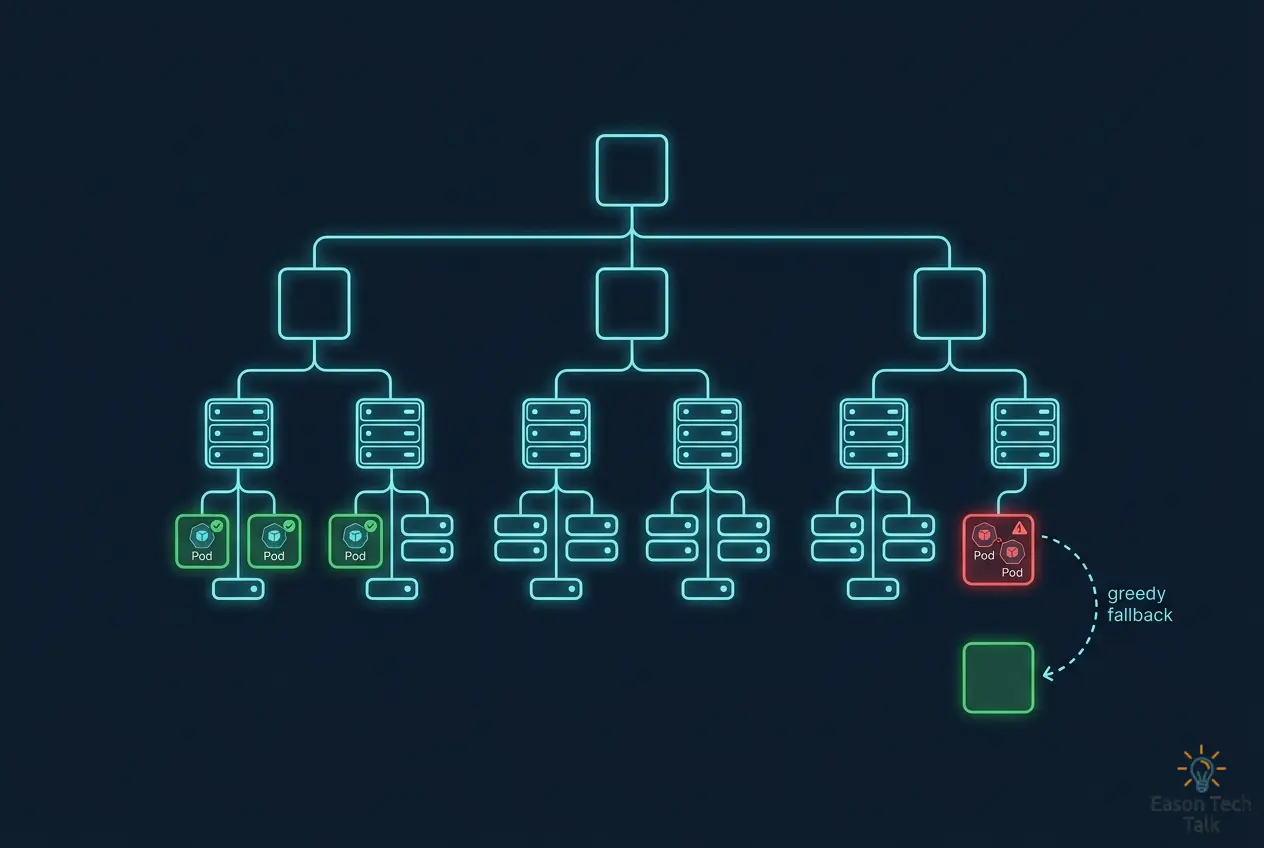
一個 Kueue 測試 cleanup:看懂 TAS 的 rank 與 greedy assignment
在跑 GPU 或 TPU 的分散式訓練時,我們常常希望同一組 Pod 能被放在物理位置比較近的機器上(例如同一個機架或同一個資料中心區塊),因為節點之間距離越近,網路延遲越低,訓練效率就越好。Kueue1 提供的 Topology Aware Scheduling(TAS)機制,就是在解決這個問題:它會在 workload 進入佇列時,根據節點的拓撲位置(哪個區塊、哪個機架、哪台主機)提前算好一份「每個 Pod 要放在哪裡」的位置安排表。...
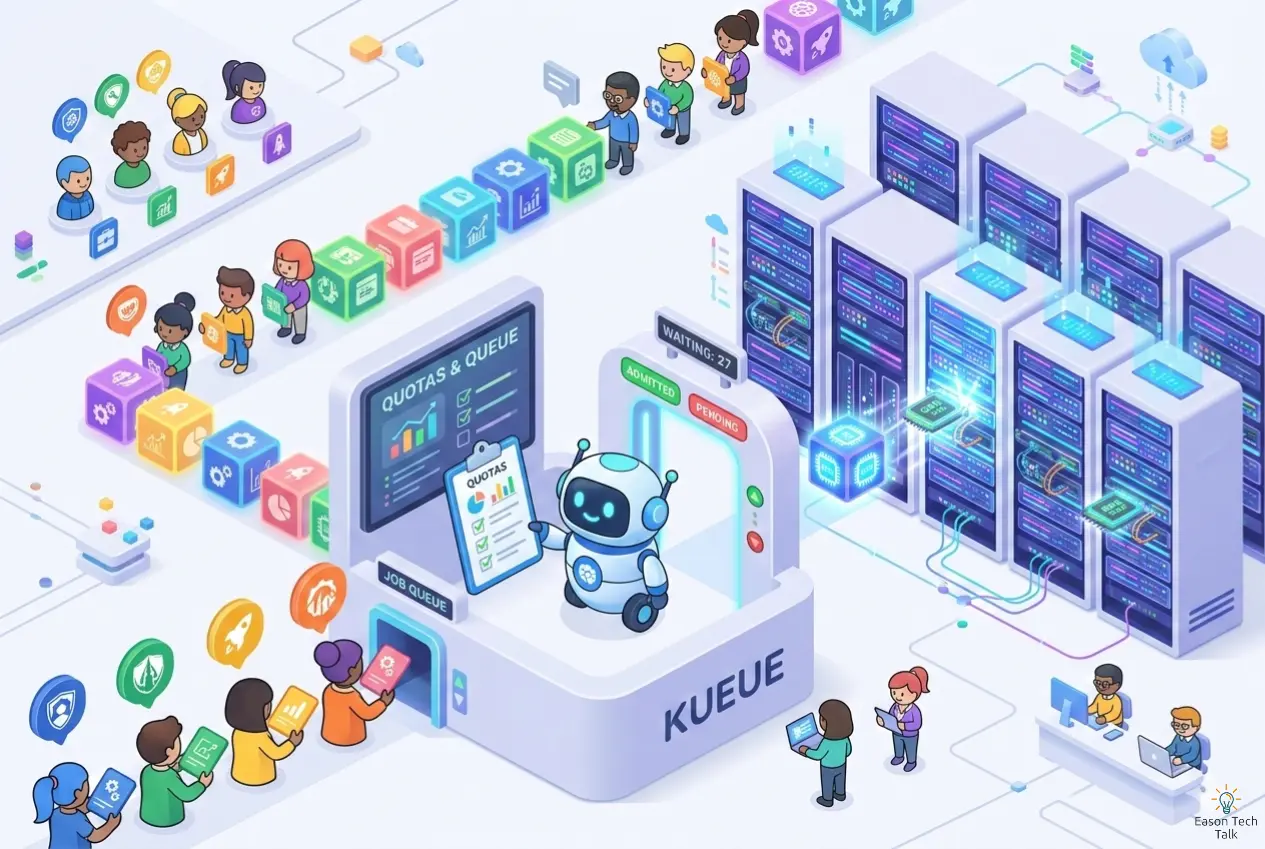
Kueue 快速上手:在 Kubernetes 上佇列管理共享 GPU/TPU 資源
這篇文章幫助你在 10 分鐘內了解 Kueue 是什麼、為什麼需要它、以及如何在共享 GPU/TPU 叢集上使用它。
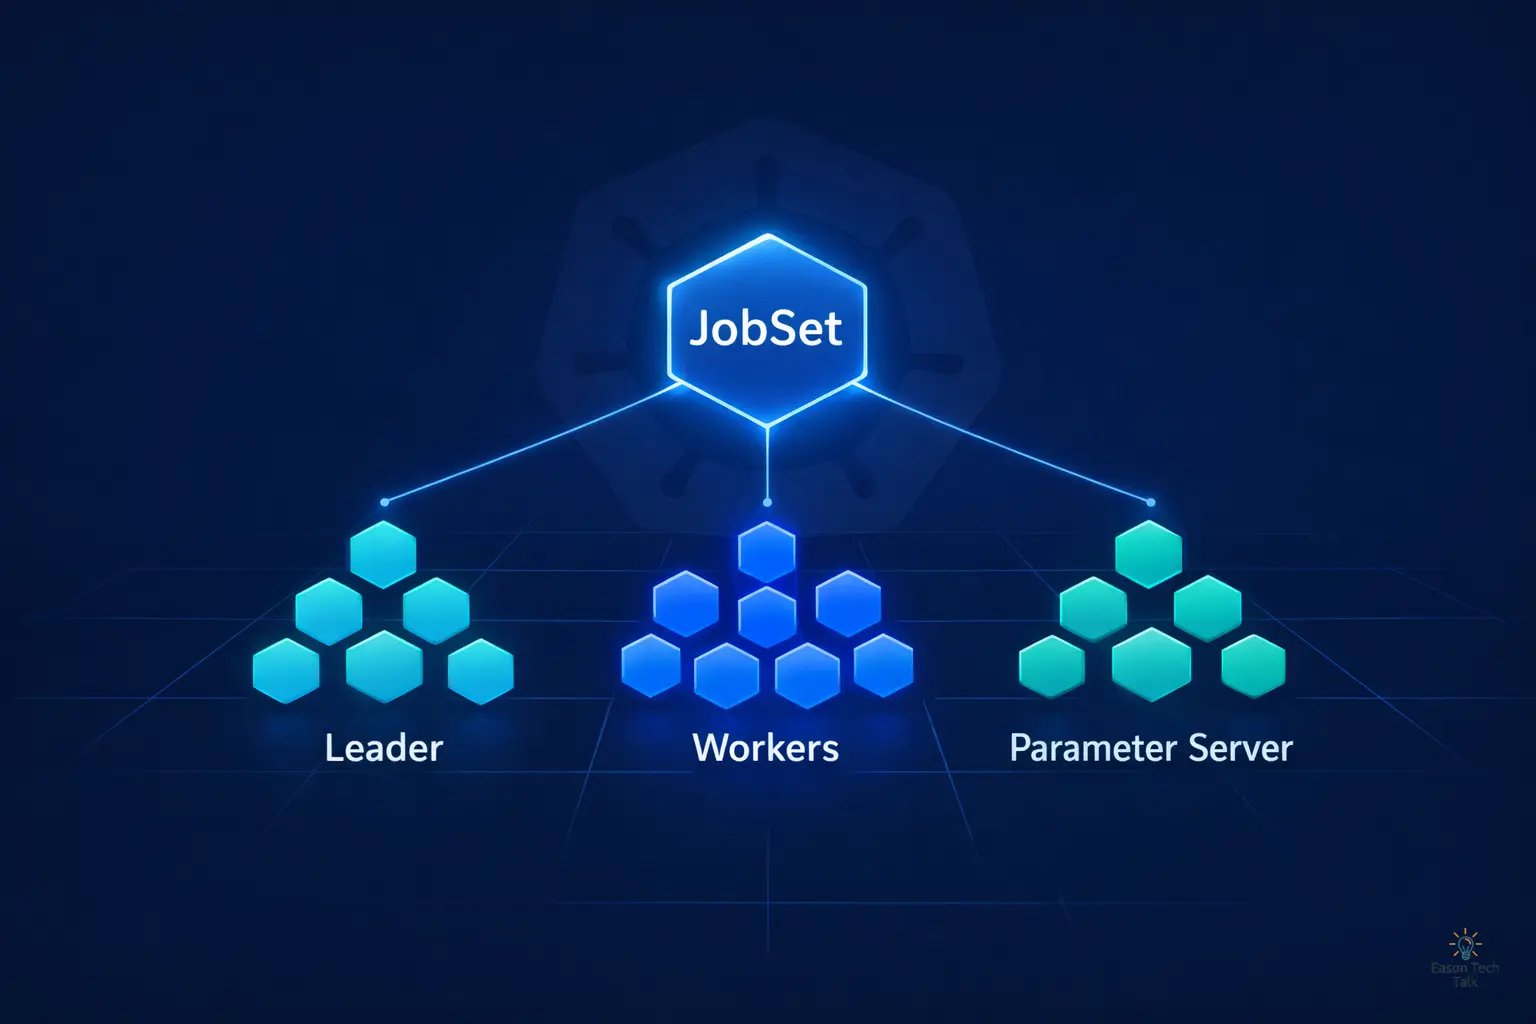
JobSet:讓 Kubernetes 真正駕馭多 Job 工作負載
一句話理解 JobSet: 如果 Kubernetes Job 是「單兵作戰」,JobSet 就是「協同作戰的整支部隊」,一個 API 物件,統一管理多組 Job 的生命週期、網路與故障恢復。
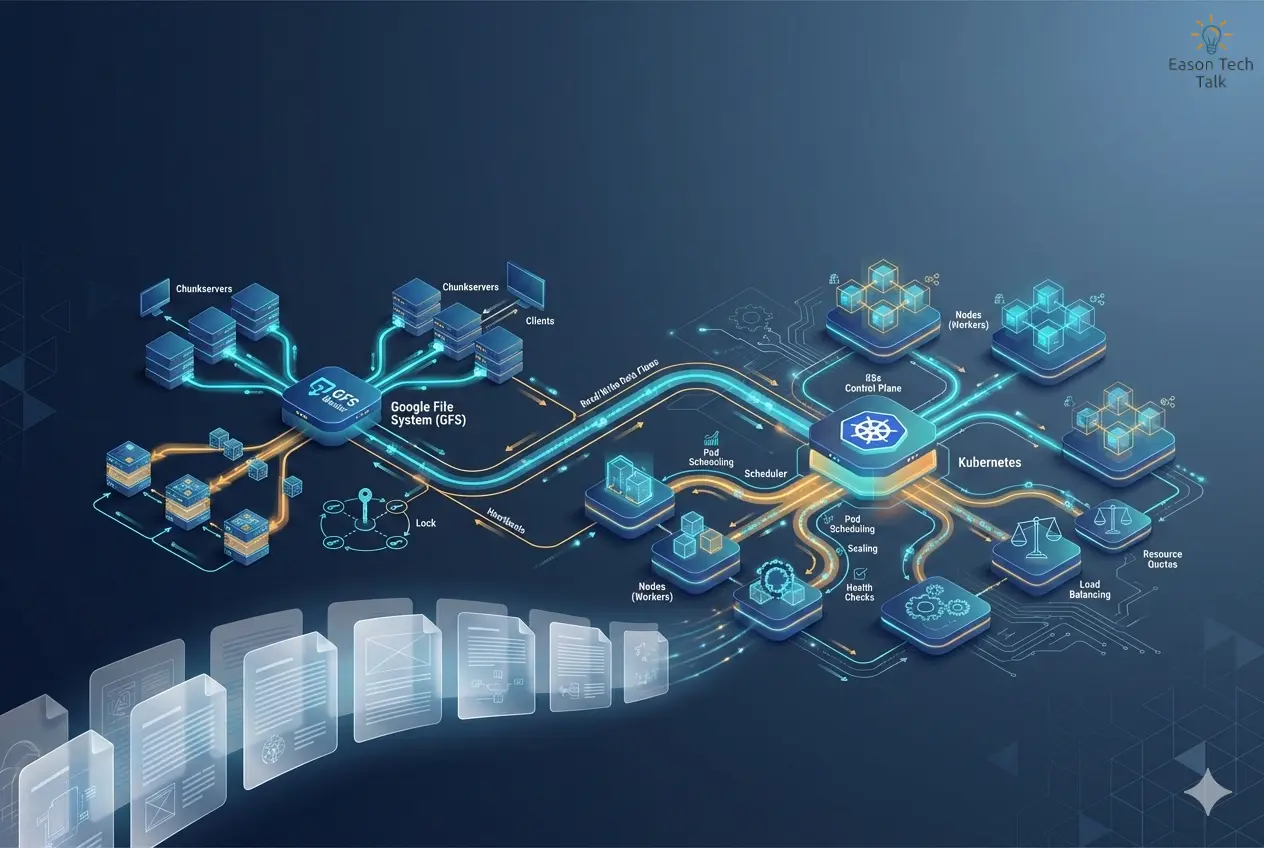
Kubernetes 工程師必讀的分散式系統閱讀清單
分散式系統對我來說是一門很有趣的學科,也為前人所奠基的基礎創造出來的科學方法驚艷:它把複雜問題拆解成有條理、可驗證的步驟,讓我們能打造在大規模下仍然穩定且高效能的系統。
GKE AI 系列:在 TPU 上用 JAX 跑第一個訓練工作
訓練大型機器學習模型需要專用硬體。Google 的 Tensor Processing Units (TPUs) 是其中最適合的晶片之一。不過一開始接觸 TPU 常常很卡:你得理解晶片配置、設定節點集區、管理資源。看了大量文件、排錯幾個小時後,還是很容易迷路。
工程師的深度工作實踐指南(讓我不再累死的工作方法)
作為一名熱衷於生產力的工程師,我花了很多時間研究如何提升工作效率。
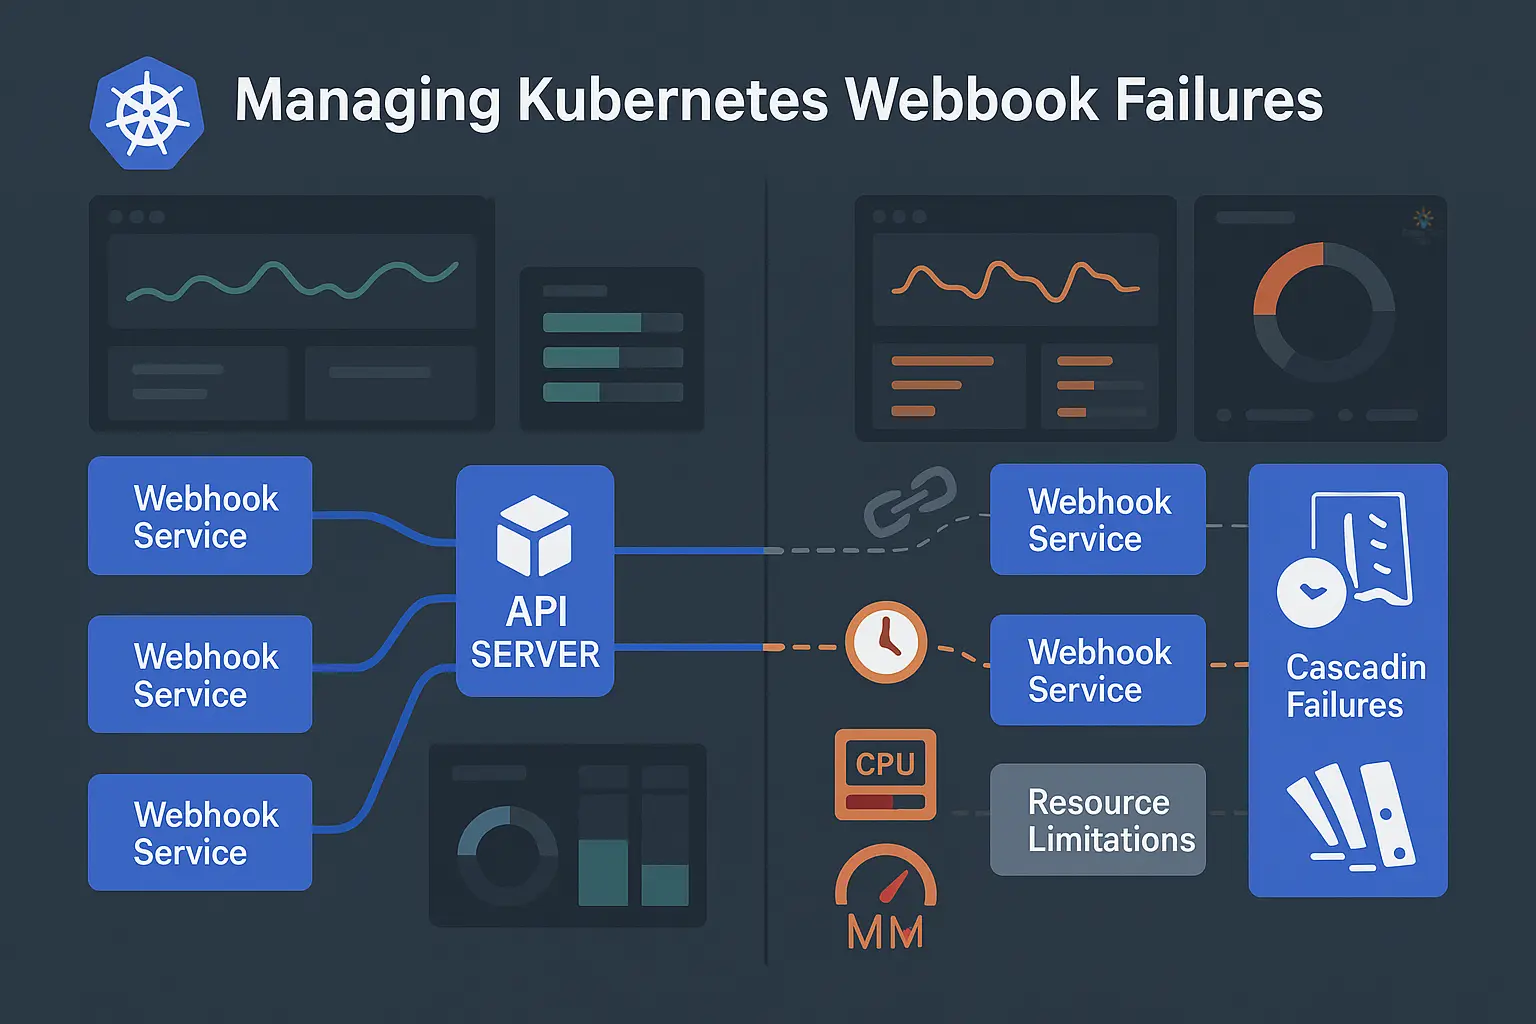
管理 Kubernetes Webhook 故障:從診斷到解決方案
在現代雲原生架構中,Kubernetes Admission Webhook 扮演著至關重要的角色,允許我們擴充和自定義 Kubernetes 的行為,而無需修改核心代碼。然而,這種強大的功能也帶來了潛在的風險 — 當 webhook 發生故障時,可能會對整個叢集造成嚴重影響,甚至導致系統性的服務中斷。
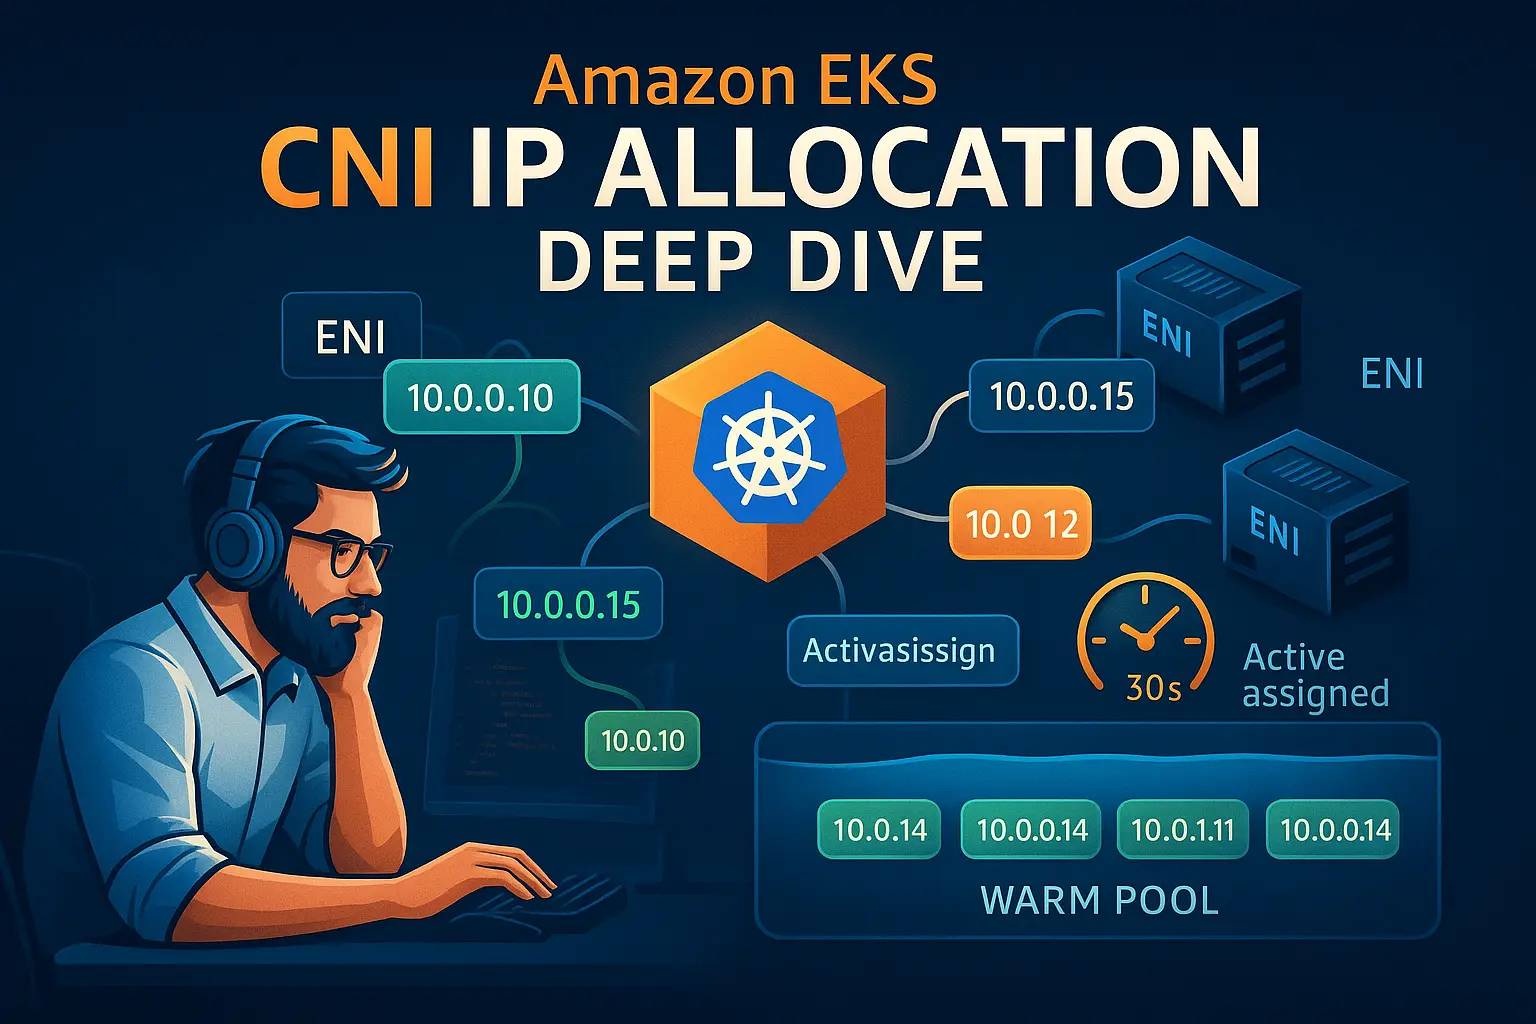
深入解析 Amazon EKS CNI 外掛在快速擴縮期間的 IP 配置難題
想像這樣一個場景:看似平常的星期五午後,生產環境突然爆發重大事件,背後牽扯出一連串複雜的 IP 配置失敗,甚至可能把整個 Kubernetes 叢集拖垮。這篇文章會深入拆解 CNI 外掛設定裡容易被忽略的風險,還原一場幾乎演變成災難的擴縮事件,並整理出避免 IP 耗盡的實務做法。跟著我一起釐清 failed to assign an IP address...
AWS Taipei 區域 (ap-east-2) 正式啟用:完整啟用指南與成本分析
2025 年對台灣雲端產業而言是歷史性的一年,AWS 正式在台北啟用全新的資料中心 (ap-east-2),三大公有雲皆齊聚一堂。這不僅象徵著台灣在全球雲端版圖的重要地位,更為在地企業帶來前所未有的數位轉型契機。透過本地化的雲端基礎設施,企業可享受毫秒級的延遲優化、完整的資料主權保護,以及更具競爭力的營運成本。本文將深入剖析 AWS Asia Pacific (Taipei) 區域的核心優勢、提供完整的啟用實作指南,並進行詳細的跨區域成本分析,協助您充分發揮這項新服務的價值。
利用 AWS 自動診斷工具簡化 EBS CSI Driver 故障排除流程
在現代 Kubernetes 環境中,持久性儲存是有狀態 (Stateful) 應用程式的重要元件。Amazon EKS 使用者通常會使用 Amazon EBS Container Storage Interface (CSI) 驅動程式來為應用程式提供持久性儲存空間 (使用...